Old-School Backend / 2026 ・ No.04
古法后端入门
第4讲 徒手和数据库对话 ── JDBC、SQL 注入、事务
发布
上一讲只用 JDK 接收了 HTTP。这次轮到数据库。第 1 讲里只是把一行 SQL 交给 Spring 的 JdbcClient,而在它下面,Java 的标准窗口 JDBC 打开连接、发送 SQL、一行一行地接收结果。
这次只用一个驱动和 PostgreSQL 对话。连接的分量、忘记关闭、拼接字符串的 SQL、类型与 null、批量写入、中途失败时会怎样,都在自己的数据库上实测。
徒手和数据库对话
新井SQL 我会写。select、insert、update。
古井那么,按用户输入的名字查申请的 SQL,你在 Java 里怎么造?
新井把字符串拼起来……“where applicant = '”+名字+“'”。
古井今天就从这一行让我的寿司费出现在你的画面上开始。
全 15 讲路线图(当前:第 4 讲)
- 连接 ── 建立一个连接要往返 6 次。select 1 执行 100 次,每次连接 1,582 ms,复用 29 ms(实测与 Wireshark)
- 忘记关闭 ── 到 97 个时数据库拒绝了(实测)
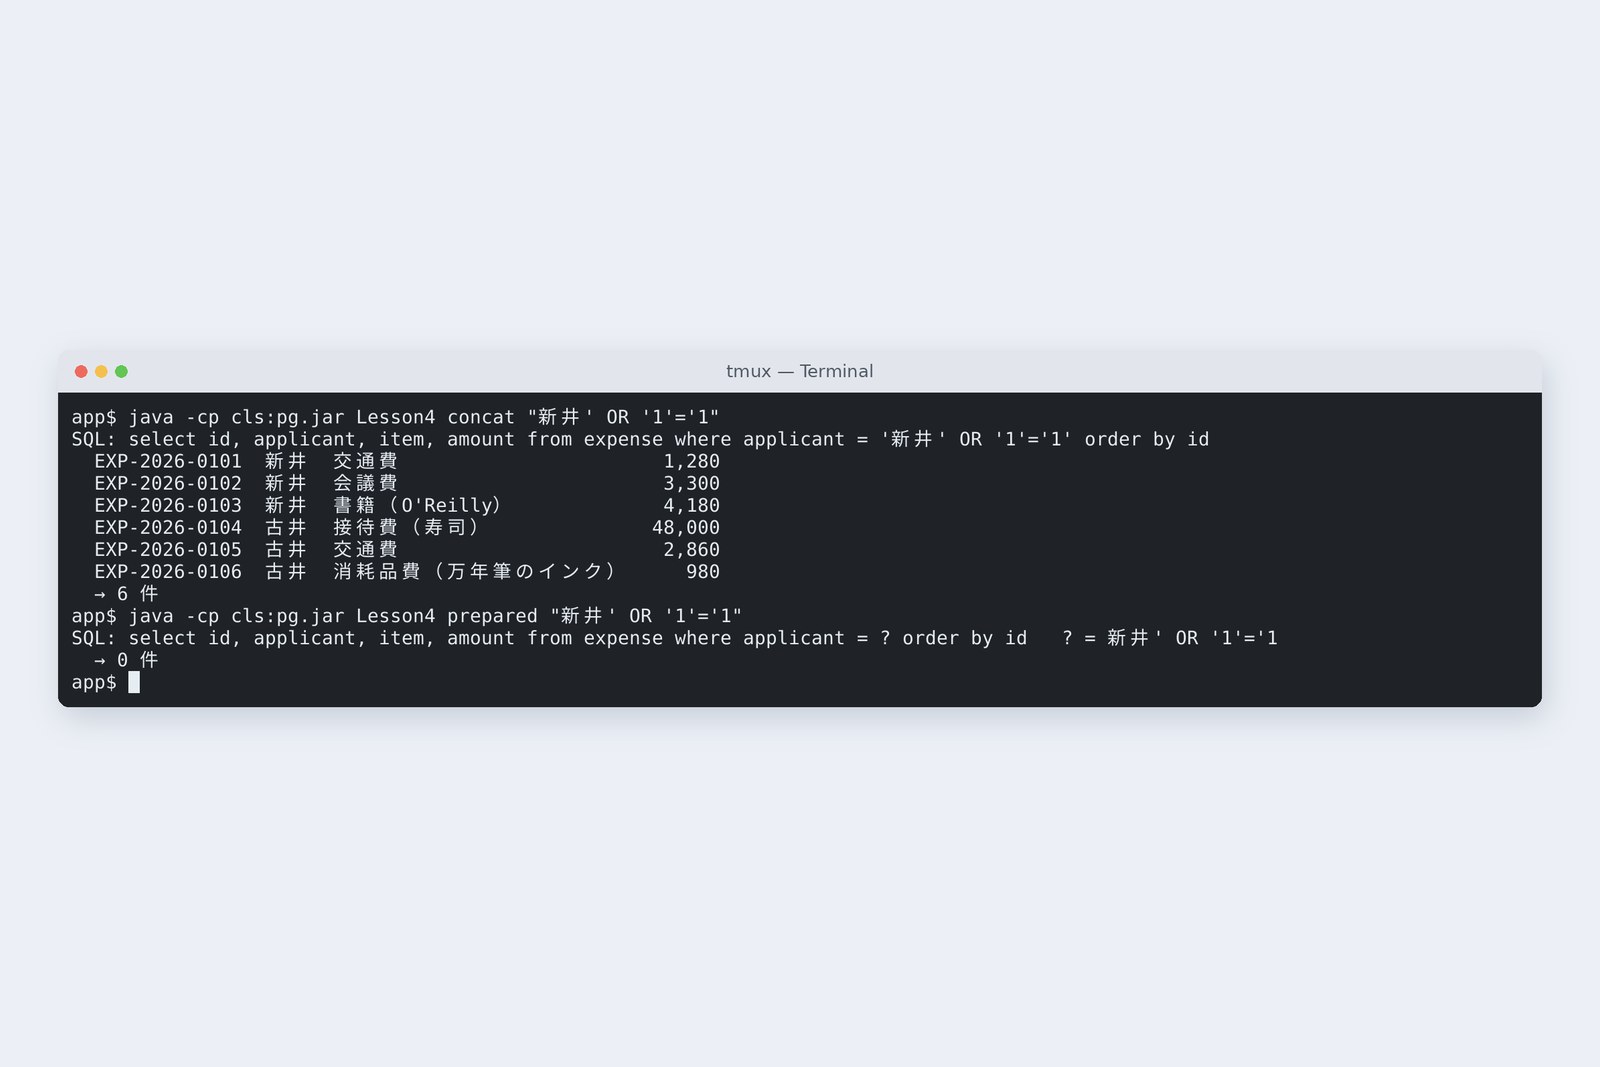
- SQL 注入 ── 拼接字符串,连别人的申请都出来了。用占位符则是 0 件(实测、数据库日志与 Wireshark)
- 类型与 null ── 没有合计时 getLong 返回 0(实测)
- 批量写入与事务 ── 1,000 行从 385 ms 到 22 ms。失败时留下了只有一半的申请(实测)
舞台是第 1 讲的三台机器。从申请服务器(192.168.1.20)连接数据库服务器(192.168.1.30,名字是 db.internal)上的 PostgreSQL 16。用到的只有 PostgreSQL 的 JDBC 驱动(postgresql-42.7.14.jar,1.2 MB)。练习程序是 Lesson4.java(不计空行 238 行)。为了这一讲,给申请表加了申请人(applicant)列,重新放入新井和古井各 3 件申请。确认是谁登录的话题,在第 11 讲。
连接:一个连接有多重
JDBC 是 Java 使用数据库的标准窗口(java.sql 包)。窗口的形状是定好的,里面由各个数据库的驱动来实现。古老的代码里常留着 Class.forName("org.postgresql.Driver") 这句咒语,但现在的驱动会在 jar 里写上自己的名字(META-INF/services/java.sql.Driver),只用 DriverManager.getConnection 就能连上。
# 一个连接有多重(同一 JVM 里连 3 次),以及 select 1 执行 100 次
getConnection 1 回目  375.0 ms
getConnection 2 回目  34.5 ms
getConnection 3 回目  14.6 ms
select 1 を 100 回:毎回つなぐ 1582 ms / 1本を使い回す 29 ms
一个连接有多重(往返用 Wireshark,时间为实测)
第 1 次的 375 ms 还包括加载驱动类的时间。第 3 次也要 14.6 ms。select 1 本身 0.3 ms 就结束了,光是连接就要它的 50 倍。用 Wireshark 数里面的内容:TCP 握手之后,询问是否使用 SSL,发送用户名和数据库名,确认密码(SCRAM-SHA-256。不发送密码本身,而是用哈希 4,096 次后的值互相确认)2 次往返,接着是驱动的设置,到第 7 次往返 SQL 才送到。而且数据库这边,每个连接都会创建一个进程。
所以业务应用不会丢掉连好的连接,而是把它放进池(连接池)里复用。第 1 讲的 Spring Boot 里 HikariCP 持有 10 个连接,就是这个原因。
忘记关闭,数据库就会拒绝
用完的连接要用 close() 还回去。忘记还会怎样?我们一直打开连接,不关闭、一直拿着。
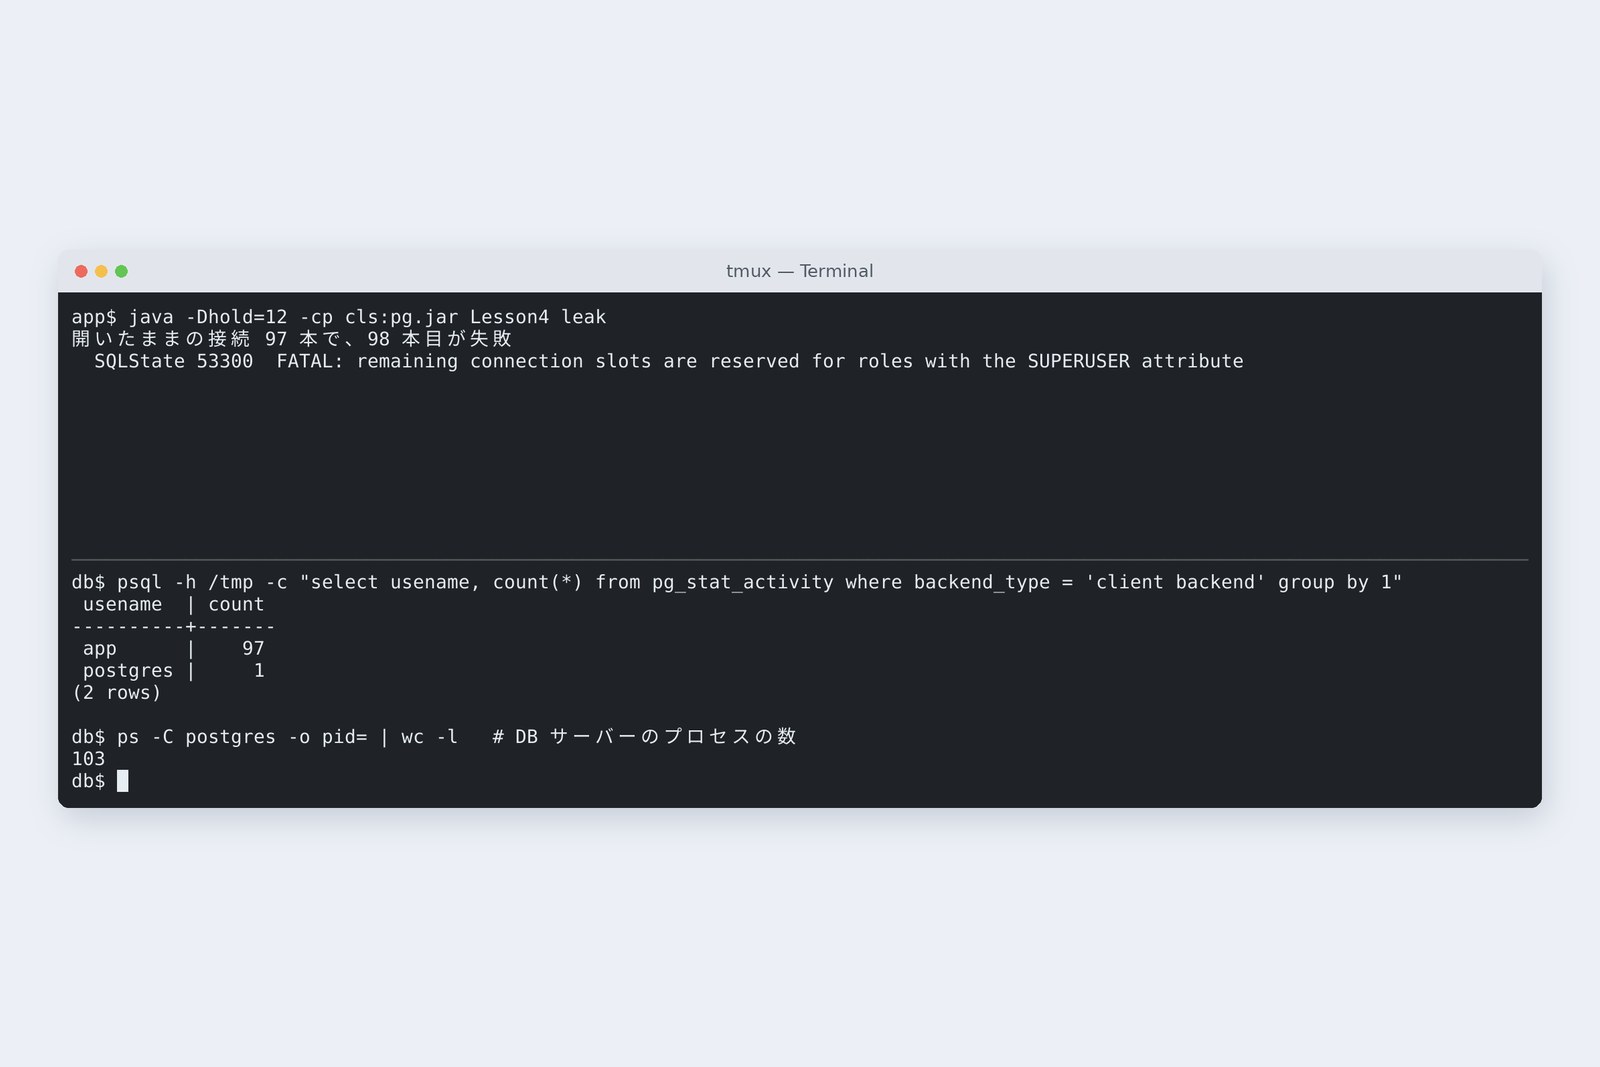
开到第 97 个都没问题,第 98 个被数据库拒绝了。PostgreSQL 同时连接数的上限默认是 100 个,其中 3 个留给管理员。上限是整个数据库共用的,所以只要某个应用泄漏连接,使用同一个数据库的其他应用也连不上了。连接池也一样,借了不还,池子很快就空了。
防止忘记归还的写法,是 Java 7 起的 try(try-with-resources)。
try (Connection c = DriverManager.getConnection(URL, USER, PASS);   // 在 ( ) 里打开的东西
     PreparedStatement ps = c.prepareStatement(sql);
     ResultSet r = ps.executeQuery()) {
    …
}                                       // 在这里按相反顺序 close(即使出了异常)
在 ( ) 里打开的东西,离开代码块时一定会被关闭,包括因异常跳出的情况。从连接池借来的连接,close() 的意思不是断开,而是“还回池里”。
拼接字符串的 SQL
用最直白的方式,写新井查看自己申请的画面。把申请人的名字拼进 SQL 的字符串里。
String sql = "select id, applicant, item, amount from expense where applicant = '" + who + "' order by id";
try (Connection c = DriverManager.getConnection(URL, USER, PASS);
     Statement s = c.createStatement();
     ResultSet r = s.executeQuery(sql)) {
    while (r.next()) { … r.getString("item") … r.getBigDecimal("amount") … }
}
# 用拼接字符串造 SQL 的版本,传入申请人的名字
SQL: select id, applicant, item, amount from expense where applicant = '新井' order by id
  EXP-2026-0101  新井  交通費                       1,280
  EXP-2026-0102  新井  会議費                       3,300
  EXP-2026-0103  新井  書籍(O'Reilly)             4,180
  → 3 件
SQL: select id, applicant, item, amount from expense where applicant = '古井' order by id
  EXP-2026-0104  古井  接待費(寿司)              48,000
  EXP-2026-0105  古井  交通費                       2,860
  EXP-2026-0106  古井  消耗品費(万年筆のインク)     980
  → 3 件
SQL: select id, applicant, item, amount from expense where applicant = '新井' OR '1'='1' order by id
  EXP-2026-0101  新井  交通費                       1,280
  EXP-2026-0102  新井  会議費                       3,300
  EXP-2026-0103  新井  書籍(O'Reilly)             4,180
  EXP-2026-0104  古井  接待費(寿司)              48,000
  EXP-2026-0105  古井  交通費                       2,860
  EXP-2026-0106  古井  消耗品費(万年筆のインク)     980
  → 6 件
“新井”就是新井的 3 件,“古井”就是古井的 3 件。到这里都正常。可是在名字栏里输入 新井' OR '1'='1,6 件全都出来了,连古井的接待费(寿司)48,000 日元也在。输入中的 ' 把 SQL 的字符串闭合了,后面的 OR '1'='1' 被当作“SQL 语句”来读。“申请人是新井,或者 1 等于 1”对任何一行都成立,于是返回了所有人的申请。这就是 SQL 注入。
即使没有恶意也会坏。在按项目查找的画面里,查新井买的 O'Reilly 的书。
# 按项目查找(拼接版)。查 O'Reilly 的书时
SQL: select id, applicant, item, amount from expense where applicant = '新井' and item like '%O'Reilly%' order by id
  PSQLException: Unterminated string literal started at position 96 in SQL select id, applicant, item, amount from expense where applicant = '新井' and item like '%O'Reilly%' order by id. Expected  char
SQL: select id, applicant, item, amount from expense where applicant = '新井' and item like '%Reilly%' order by id
  EXP-2026-0103  新井  書籍(O'Reilly)             4,180
  → 1 件
一个撇号,就让 SQL 的语法坏掉了。人名(O'Brien)和公司名里,这是很普通的字符。而且这个例子只是“被看到”,从同一个漏洞还能改写条件,修改或删除别人的数据。不要把输入直接拼进 SQL 语句。这不是喜好,而是规矩。
占位符:把语句和值分开
改法是在放值的地方写 ?(占位符),值用 setString 等另外传入。
String sql = "select id, applicant, item, amount from expense where applicant = ? order by id";
try (Connection c = DriverManager.getConnection(URL, USER, PASS);
     PreparedStatement ps = c.prepareStatement(sql)) {
    ps.setString(1, who);                 // 放进第 1 个 ? 的“值”
    try (ResultSet r = ps.executeQuery()) { … }
}
# 占位符(?)版,传入同样的文字
SQL: select id, applicant, item, amount from expense where applicant = ? order by id   ? = 新井
  EXP-2026-0101  新井  交通費                       1,280
  EXP-2026-0102  新井  会議費                       3,300
  EXP-2026-0103  新井  書籍(O'Reilly)             4,180
  → 3 件
SQL: select id, applicant, item, amount from expense where applicant = ? order by id   ? = 新井' OR '1'='1
  → 0 件
SQL: select id, applicant, item, amount from expense where applicant = ? and item like ? order by id   ? = 新井, %O'Reilly%
  EXP-2026-0103  新井  書籍(O'Reilly)             4,180
  → 1 件
传入同样的 新井' OR '1'='1,结果是 0 件。因为没有“名叫 新井' OR '1'='1 的人”。O'Reilly 的书也好好地找到了。用数据库服务器的日志,比较送达的内容。
# 数据库服务器日志(log_statement=all)。上面是拼接版,下面是占位符版
23:53:40 LOG:  execute <unnamed>: select id, applicant, item, amount from expense where applicant = '新井' OR '1'='1' order by id
23:53:40 LOG:  execute <unnamed>: select id, applicant, item, amount from expense where applicant = $1 order by id
23:53:40 DETAIL:  parameters: $1 = '新井'' OR ''1''=''1'
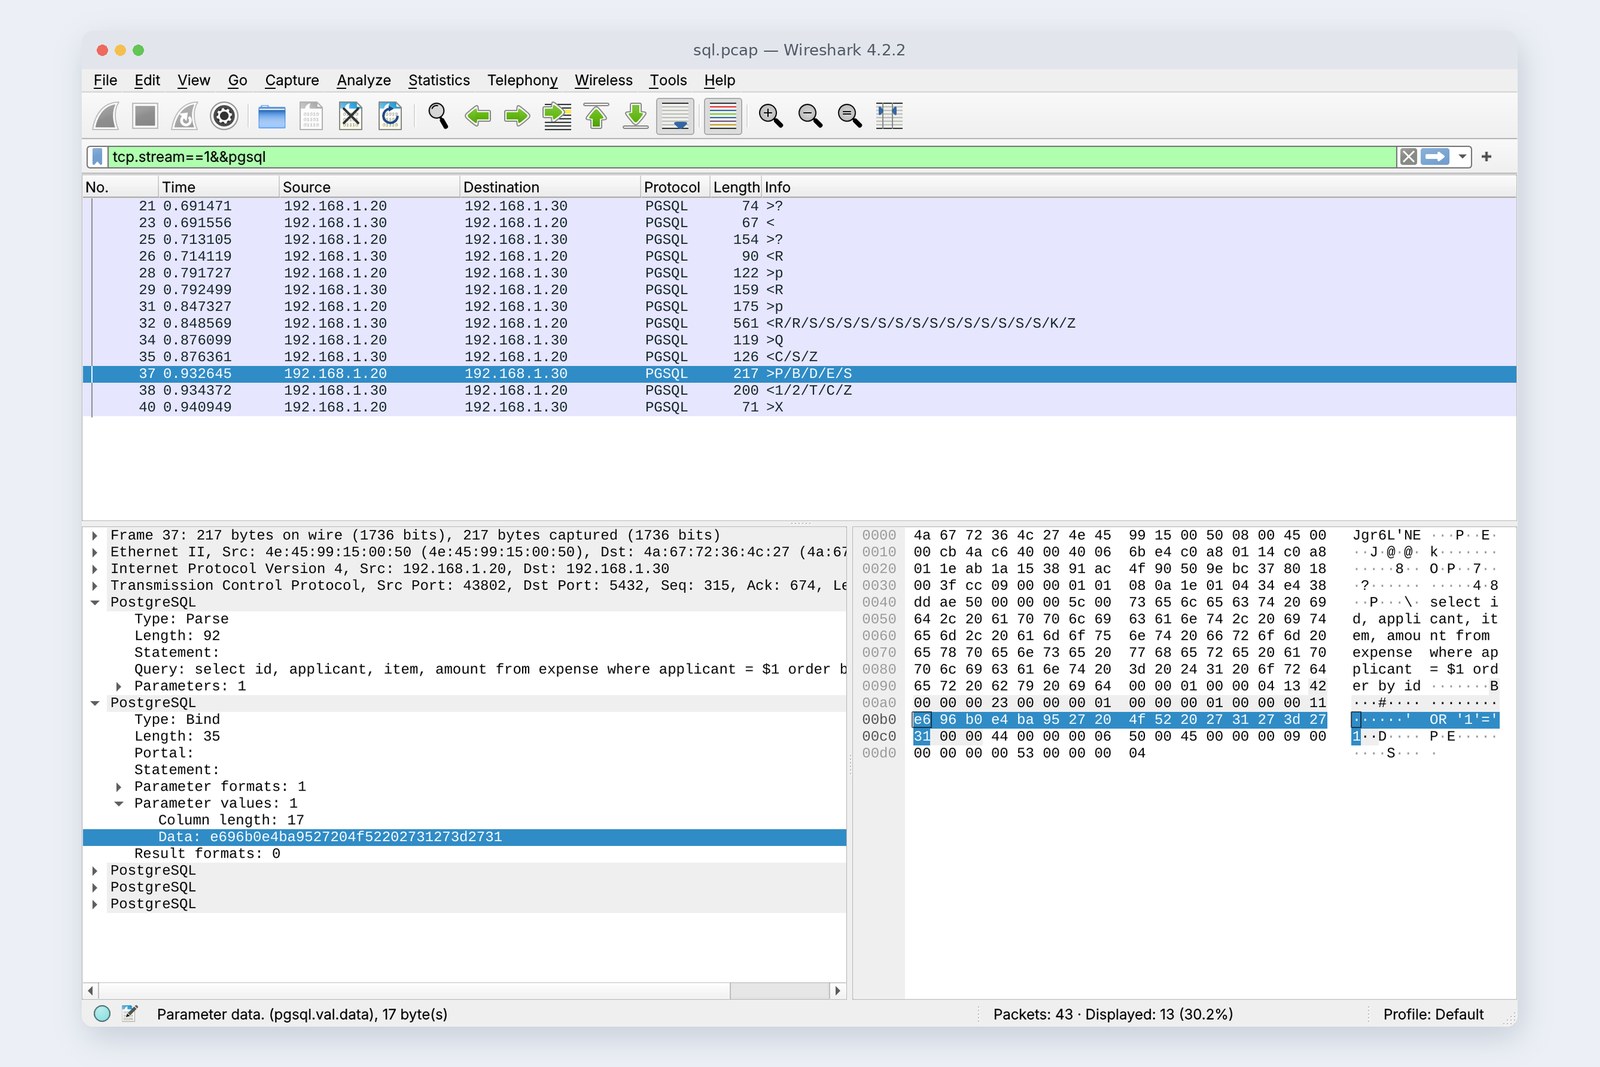
拼接时值变成了语句。占位符把语句和值分开发送
拼接版的输入溶进了 SQL 语句里送达。从数据库来看,分不清哪些是用户输入、哪些是程序员写的 SQL。占位符版的语句保持 applicant = $1,值装在另一个箱子(Bind)里送达。数据库只把值当作值来用,所以不管放了多少引号,语句都不会变。第 1 讲的 JdbcClient 用 ? 和 .params(…) 来写,也是因为里面在做这件事。
新井古井前辈,接待费(寿司)48,000 日元……
古井就当没看见。还有,从今天起谁再把输入拼进 SQL,寿司就不请了。
只靠 ? 还不够的地方
占位符也有它管不到的地方。先看 LIKE。
# LIKE 的 % 和 _,放进 ? 里依然表示“任意”
item like ?  ← "%%%"         → 3 件
item like ? escape '\'  ← "%\%%" → 0 件
item like ?  ← "%_%"         → 3 件
item like ? escape '\'  ← "%\_%" → 0 件
在搜索词里放 % 或 _,即使放进了 ?,在 LIKE 里依然表示“任意”“任意一个字符”,3 件全部命中。这不是 SQL 注入,但会变成“搜 100% 就全部出来”的 bug。用 \ 转义后再传入就是 0 件。PostgreSQL 默认的转义字符也是 \,但各个数据库不同,用 escape 写明比较稳妥。
# 排序的列名不能用 ?。列表用 any(?)
order by ?  ← "amount desc"  → [EXP-2026-0101 1280, EXP-2026-0102 3300, EXP-2026-0103 4180]
許可した列名だけつなぐ order by amount desc → [EXP-2026-0103 4180, EXP-2026-0102 3300, EXP-2026-0101 1280]
id = any(?)  ← [EXP-2026-0101, EXP-2026-0103] → 2 件
? 里只能放值。把排序的列名写成 ?,就变成按“amount desc”这串文字排序,排序不起作用,也不报错。想让画面选择列名、表名或 asc/desc 时,只把从允许的名字清单里选出来的拼进 SQL。用多个编号查找的 in (…),在 PostgreSQL 里可以把数组放进一个 ?,写成 = any(?)。
类型与 null
结果要从 ResultSet 里选好类型取出。用各种方式读取一件申请都没有的人(中井)的合计。
# 用各种 get 读取没有申请的人(中井)的合计
新井 の合計
  getBigDecimal → 8760.00
  getLong       → 8760   wasNull() = false
  getDouble     → 8760.0
  getObject(LocalDate) → 2026-10-28
中井 の合計
  getBigDecimal → null
  getLong       → 0   wasNull() = true
  getDouble     → 0.0
  getObject(LocalDate) → null
会議費 3300 の税込(numeric のまま DB で計算)
  getBigDecimal → 3630.000   getDouble → 3630.0   getString(amount) → 3300.00
中井的合计在 SQL 里是“什么都没有”(NULL)。getBigDecimal 返回了 null,getLong 却返回 0,getDouble 返回 0.0。long 和 double 是不能存 null 的类型,所以 JDBC 返回 0,“其实是 NULL”只能在紧接着的 wasNull() 里知道。“合计 0 日元”和“还没有申请”在业务上是两回事。钱用 getBigDecimal(第 2 讲),日期用 getObject(…, LocalDate.class) 来读,是基本做法。含税的计算,也是保持 numeric 在数据库里算,得到准确的 3630.000。
批量写入
设想月底把 1,000 件交通费一次性登记的处理。同样的 insert,用 4 种方式各写 3 次。
# 写入 1,000 行(同样做 3 次)
    逐条(自动提交)                  424 ms / 385 ms / 375 ms
    逐条(提交 1 次)                  60 ms /  55 ms /  54 ms
    addBatch                           29 ms /  40 ms /  30 ms
    addBatch+reWriteBatchedInserts    23 ms /  22 ms /  22 ms
写入 1,000 行:提交次数与往返次数(实测)
JDBC 一开始是每条语句自动提交。每次提交,数据库都要等写入磁盘,直到能说“确实记录了”,1,000 行就要等 1,000 次。只是放进一个事务里,385 ms 就变成了 55 ms。再用 addBatch 一起发送,往返减少;加上驱动的 reWriteBatchedInserts=true,驱动会改写成多行 insert,22 ms。实验的数据库在同一台机器里,往返约 0.04 ms,如果隔着真正的网络,减少往返的效果会更明显。
中途失败时
出差的申请分成抬头(合计)和明细(新干线、酒店)两张表来写。明细的金额列最多 8 位(含小数 2 位),酒店费 1,000,000 日元放不进去。就这样写写看。
# 1 行抬头+2 行明细的申请。第 2 行的金额超出列的位数
自動コミットのまま
  見出し 1 行 OK
  明細 1(新幹線 12860)OK
  失敗: ERROR: numeric field overflow
  → 残ったもの:見出し 1 行、明細 1 行
setAutoCommit(false) と rollback
  見出し 1 行 OK
  明細 1(新幹線 12860)OK
  失敗: ERROR: numeric field overflow
  rollback
  → 残ったもの:見出し 0 行、明細 0 行
保持自动提交,会留下只有一半的申请(实测)
保持自动提交时,失败之前的 2 行已经确定了,留下了只有抬头和 1 行明细的申请。合计 1,012,860 日元的申请,明细只有新干线的 12,860 日元。财务看到会晕过去。用 setAutoCommit(false) 开始,全部成功就 commit,有一个失败就 rollback,什么都不会留下。
c.setAutoCommit(false);                 // 从这里开始,合成一个整体
try {
    header.executeUpdate();             // 抬头
    for (…) line.executeUpdate();       // 明细
    c.commit();                         // 全部成功了,就确定
} catch (SQLException e) {
    c.rollback();                       // 只要有一个失败,就全部当作没发生
    throw e;
}
# 数据库服务器日志(setAutoCommit(false) 的那次)
23:53:45 LOG:  execute <unnamed>: insert into expense (id, applicant, applied_on, item, amount, status) values ('EXP-2026-0107', '新井', '2026-10-30', '出張', $1, 'submitted')
23:53:45 DETAIL:  parameters: $1 = '1012860'
23:53:45 LOG:  execute <unnamed>: insert into expense_line (expense_id, line_no, item, amount) values ('EXP-2026-0107', $1, $2, $3)
23:53:45 DETAIL:  parameters: $1 = '1', $2 = '新幹線', $3 = '12860'
23:53:45 ERROR:  numeric field overflow
23:53:45 DETAIL:  A field with precision 8, scale 2 must round to an absolute value less than 10^6.
23:53:45 STATEMENT:  insert into expense_line (expense_id, line_no, item, amount) values ('EXP-2026-0107', $1, $2, $3)
23:53:45 LOG:  execute S_1: ROLLBACK
数据库日志里,失败之后也送达了 ROLLBACK。让一组工作“要么全做、要么全不做”,就是事务;Spring 的 @Transactional 里面,运行的正是这些 setAutoCommit(false)、commit、rollback。两个人同时修改同一件申请的话题,在第 9 讲讨论。
在自己的电脑上验证
| 想试的事 | 命令・写法 |
|---|---|
| 带上驱动直接运行源文件 | java -cp postgresql-42.7.14.jar Lesson4.java conn |
| 把送达数据库的 SQL 写进日志 | alter system set log_statement = 'all'; select pg_reload_conf(); |
| 当前的连接数 | select usename, count(*) from pg_stat_activity group by 1; |
| 连接上限 | show max_connections; |
| 确认是否为 NULL | long n = r.getLong(1); if (r.wasNull()) … |
| 把批量写入改成多行 insert | jdbc:postgresql://…/expenses?reWriteBatchedInserts=true |
日志设置只在练习用的数据库上做。在生产环境设成 log_statement = 'all',日志很快就会爆满,输入的值也会原样留下。没有 PostgreSQL 的话,可以用 Docker 的 postgres:16 镜像轻松搭一个(第 15 讲会用到)。
结 — 一页总结与下一讲
- JDBC 是 Java 的标准窗口。放一个驱动 jar,就能用 DriverManager.getConnection 连接。
- 一个连接很重(SQL 之前要往返 6 次,数据库那边要一个进程)。放进池里复用。
- 忘记关闭,到 97 个整个数据库就拒绝连接。用 try-with-resources 一定归还。
- 不要把输入拼进 SQL 语句。拼接后出现了别人的申请,O'Reilly 让语法坏掉。用占位符把语句和值分开。
- ? 里只能放值。LIKE 的 % 和 _ 要转义。列名从允许的清单里选。
- 对 NULL 用 getLong 得到 0。钱用 getBigDecimal,日期用 getObject(LocalDate.class)。
- 1,000 行用事务和批量从 385 ms 降到 22 ms。一组工作,要么全做、要么全不做。
新井徒手,手差不多要疼了。
古井坚持得不错。下一讲终于回到 Spring Boot。第 3 讲和这一讲徒手做的工作,由谁、怎样接手?来看 DI,以及窗口・负责人・仓库管理员这三层。
参考
- Java SE 25 API — java.sql(Connection、PreparedStatement、ResultSet)
- The Java Tutorials — The try-with-resources Statement
- PostgreSQL JDBC Driver — Initializing the Driver(reWriteBatchedInserts)
- PostgreSQL 16 — Connections and Authentication(max_connections)
- PostgreSQL 16 — SASL Authentication(SCRAM-SHA-256)
- PostgreSQL 16 — Message Flow(Parse、Bind、Execute)
- PostgreSQL 16 — Pattern Matching(LIKE と ESCAPE)
- OWASP — SQL Injection Prevention Cheat Sheet
记录是笔者于 2026 年 10 月 30 日在云端 Linux(Ubuntu 24.04,内核 6.18)上,用 OpenJDK 25.0.4、PostgreSQL JDBC 42.7.14、PostgreSQL 16.15、Wireshark 4.2.2 取得的。申请服务器和数据库服务器是在一台机器里建立的不同网络空间(network namespace),往返约 0.04 ms。时间是当时的值,每次运行都会略有不同。批量写入取 3 次,其他取 1 次的值。表中的数字和输出,全部是从当时命令输出中读取的实际值。登场人物均为虚构,寿司费也是虚构的。
古法后端入门 第4讲 — 徒手和数据库对话 / 2026.10