Old-School Backend / 2026 ・ No.13
古法后端入门
第13讲 日志与监控 ── 让人事后能读出“发生了什么”
发布
上一讲,发送 12 MB 照片的用户没有收到回复。那时,服务器日志里留下了什么?
这一讲从重读到目前为止的应用日志开始。实测不存在的 URL 变成了 500、日志里出现了散列和申请内容、一个请求的行被埋在别人的行里,然后用请求编号、结构化日志、Actuator 的数字和健康检查,把它变成事后能读的形式。最后试着停掉数据库。
12 MB 时,日志里有什么
新井12 MB 照片那次,日志里一定有个大错误。
古井看看吧。
全 15 讲路线图(当前:第 13 讲)
# 发送 12.05 MB 照片时的应用日志(全部)
10:52:56.867 INFO  [4a5dcd45] access               POST /api/v12/claims/EXP-2026-5020/receipts 413 51 ms user=arai
# 发送方
  ERR BrokenPipeError  (1070.3 ms)
日志只有 1 行,而且写的是“返回了 413”。服务器以为写了拒绝的回复,用户却没收到(上一讲 Tomcat 读掉丢弃的上限)。日志只写服务器看到的事。用户画面上发生的事,只能用别的手段得知。
- 不存在的 URL ── 打开 1 次 /favicon.ico 就是 500 和 59 行日志(实测)
- 量 ── 保持开发设置时,1 个 GET 写 5 行、533 字节(实测)
- 不该写的东西 ── 散列、SQL 的值、文件名进了日志(实测)
- 编号・数字・健康检查 ── 集中一个请求的行,用数字看,数据库停了要 30 秒(实测)
应用里加入了 Spring Boot Actuator,以及把数字按 Prometheus 格式输出的 Micrometer。日志设置改成了面向生产的如下形式。
# 面向生产的 application.properties(第 13 讲修改的部分)
logging.pattern.console=%d{HH:mm:ss.SSS} %-5level [%X{reqId:--}] %-20.20logger{0} %msg%n
management.server.port=8081
management.endpoints.web.exposure.include=health,metrics,prometheus
management.endpoint.health.show-details=always
spring.servlet.multipart.max-file-size=10MB
spring.servlet.multipart.max-request-size=10MB
不存在的 URL 是 500
浏览器不用你说,也会来取 /favicon.ico(标签页上的小图)。这是打开它 1 次时的日志。
# 打开 1 次 /favicon.ico 时的日志(修改前)
10:51:57.108 ERROR [9734d104] ApiErrors            問い合わせ番号 ERR-9734d104
org.springframework.web.servlet.resource.NoResourceFoundException: No static resource favicon.ico for request '/favico…
	at org.springframework.web.servlet.resource.ResourceHttpRequestHandler.handleRequest(ResourceHttpRequestHandler.java:…
  …(以下 at 行共 56 行,总共 59 行)
# 回复
  500  処理できませんでしたerrorId=ERR-9734d104
第 7 讲写的“其他一律 500”的处理员,把“不存在的 URL”也变成了 500,还写了 59 行堆栈。浏览器或机器人每访问一个乱七八糟的 URL,ERROR 就堆积一次,真正的 500 就被埋没了。现在改为“不存在的 URL”返回 404,也不写堆栈。
从第 7 讲起这个 500 一直都在。也就是说,没有读日志的习惯,就发现不了。
日志的量与级别
本系列为了看 SQL,一直在加 DEBUG 日志。用原样的设置(保持开发设置)和面向生产的设置,把同一个 GET 各发 500 次。
# 同一个 GET 发 500 次(已登录的新井,各 2 次)
  设置时间行数字节每件
  保持开发设置2655 ms   2500    266,514   5 行 / 533 B
  面向生产1820 ms   500     52,001    1 行 / 104 B
  保持开发设置2091 ms   2500    266,502   5 行 / 533 B
  面向生产2052 ms   500     52,002    1 行 / 104 B
# 保持开发设置时,1 个 GET 写下的行
10:53:08.968 DEBUG [c415eb98] DataSourceUtils      Fetching JDBC Connection from DataSource
10:53:08.969 DEBUG [c415eb98] findVisible          ==>  Preparing: select id, applicant, item, amount, status, version…
10:53:08.969 DEBUG [c415eb98] findVisible          ==> Parameters: EXP-2026-5001(String), 新井(String)
10:53:08.971 DEBUG [c415eb98] findVisible          <==      Total: 1
10:53:08.972 INFO  [c415eb98] access               GET /api/v11/claims/EXP-2026-5001 200 5 ms user=arai
保持开发设置时,1 个 GET 写 5 行、533 字节;面向生产时只有受理簿的 1 行、104 字节。一天 10 万件的话,就是 53 MB 与 10 MB 的差别(计算)。这个实验里时间差别并不明显,但日志写得越多,就越占磁盘和读日志的人的时间。
| 级别 | 写什么 | 这一讲的例子 |
|---|---|---|
| ERROR | 需要人来看、采取措施的事 | 意外的 500(带咨询编号) |
| WARN | 现在还能运行,但持续下去会有麻烦的事 | 连接池丢弃了坏掉的连接 |
| INFO | 业务的流程,大致每件 1 行 | 受理簿(谁・做什么・结果・时间) |
| DEBUG | 只在开发时用,生产环境关掉 | SQL 及其值 |
不该写进日志的东西
第 11 讲发现,MyBatis 的 DEBUG 日志里出现了 bcrypt 散列。重新写入用户,做了登录・收据・批准之后,统计日志。
# 登录・收据・批准后统计日志(重新写入用户后)
  bcrypt 散列保持开发设置 3面向生产 0
  密码保持开发设置 0面向生产 0
  cookie                    保持开发设置 0面向生产 0
  SQL 的值(Parameters:)保持开发设置 13 面向生产 0
  文件名保持开发设置 1面向生产 0
# 保持开发设置时出现的行(部分)
10:53:55.442 DEBUG [-] save                 ==> Parameters: arai(String), {bcrypt}$2a$10$B0GlrG… 新井(String), APPLICANT(String)
10:54:04.956 DEBUG [c128d0d7] insert               ==> Parameters: d43b4ac3-fa09-4449-9b0f-cd2e4464b185(String), EXP-2026-5020(String), 領収書(新幹線).jpg(S…
密码本身和 cookie,两种设置下都没有出现(在这个实验中,Spring Security 和 Tomcat 都没有写)。但保持开发设置时,散列和收据的文件名作为 SQL 的值出现了。前一章的 GET 例子里,受理编号和申请人的名字也作为 SQL 的值出现。日志是比数据库多得多的人会看到的地方。
面向生产的设置中,SQL 值的行没有了。日志里只写编号和结果。“是哪份申请”用受理编号就足够,内容在数据库里。
请求编号
服务器同时处理许多人的请求,日志的行是各种人的混在一起排列的。所以请求一到就编号,把编号放进日志的每一行,并在回复的头(X-Request-Id)里也返回。
# 给请求编号的处理员(RequestIdFilter.java)
@Override
protected void doFilterInternal(HttpServletRequest req, HttpServletResponse res, FilterChain chain)
        throws ServletException, IOException {
    String id = HexFormat.of().toHexDigits(ThreadLocalRandom.current().nextInt());
    MDC.put("reqId", id);
    res.setHeader("X-Request-Id", id);  // 也返回给画面,咨询时使用
    long t = System.nanoTime();
    try {
        chain.doFilter(req, res);
    } finally {
        Object user = req.getAttribute("loginUser");  // UserMdcFilter 放进去的
        access.info("{} {} {} {} ms user={}", req.getMethod(), req.getRequestURI(), res.getStatus(),
                (System.nanoTime() - t) / 1_000_000, user == null ? "-" : user);
        MDC.clear();
    }
}
把编号放进 SLF4J 的 MDC(只在该请求期间随身携带的容器),在日志格式里写上 %X{reqId},每一行都会带上编号。第 7 讲的咨询编号也统一成了这个编号。
# 让咨询编号与请求编号一致(ApiErrors.java)
@ExceptionHandler(Exception.class)  // 其他 → 500。不给看内容,用编号关联
ProblemDetail unexpected(Exception e) {
    String reqId = MDC.get("reqId");  // 第 13 讲:咨询编号与请求编号相同
    String no = "ERR-" + (reqId != null ? reqId : HexFormat.of().toHexDigits(ThreadLocalRandom.current().nextInt()));
    log.error("問い合わせ番号 {}", no, e);
    ProblemDetail p = problem(HttpStatus.INTERNAL_SERVER_ERROR, "unexpected", "処理できませんでした", "時間をおいてもう一度お試しください。続くときは問い合わせ番号をお知らせください");
    p.setProperty("errorId", no);
    return p;
}
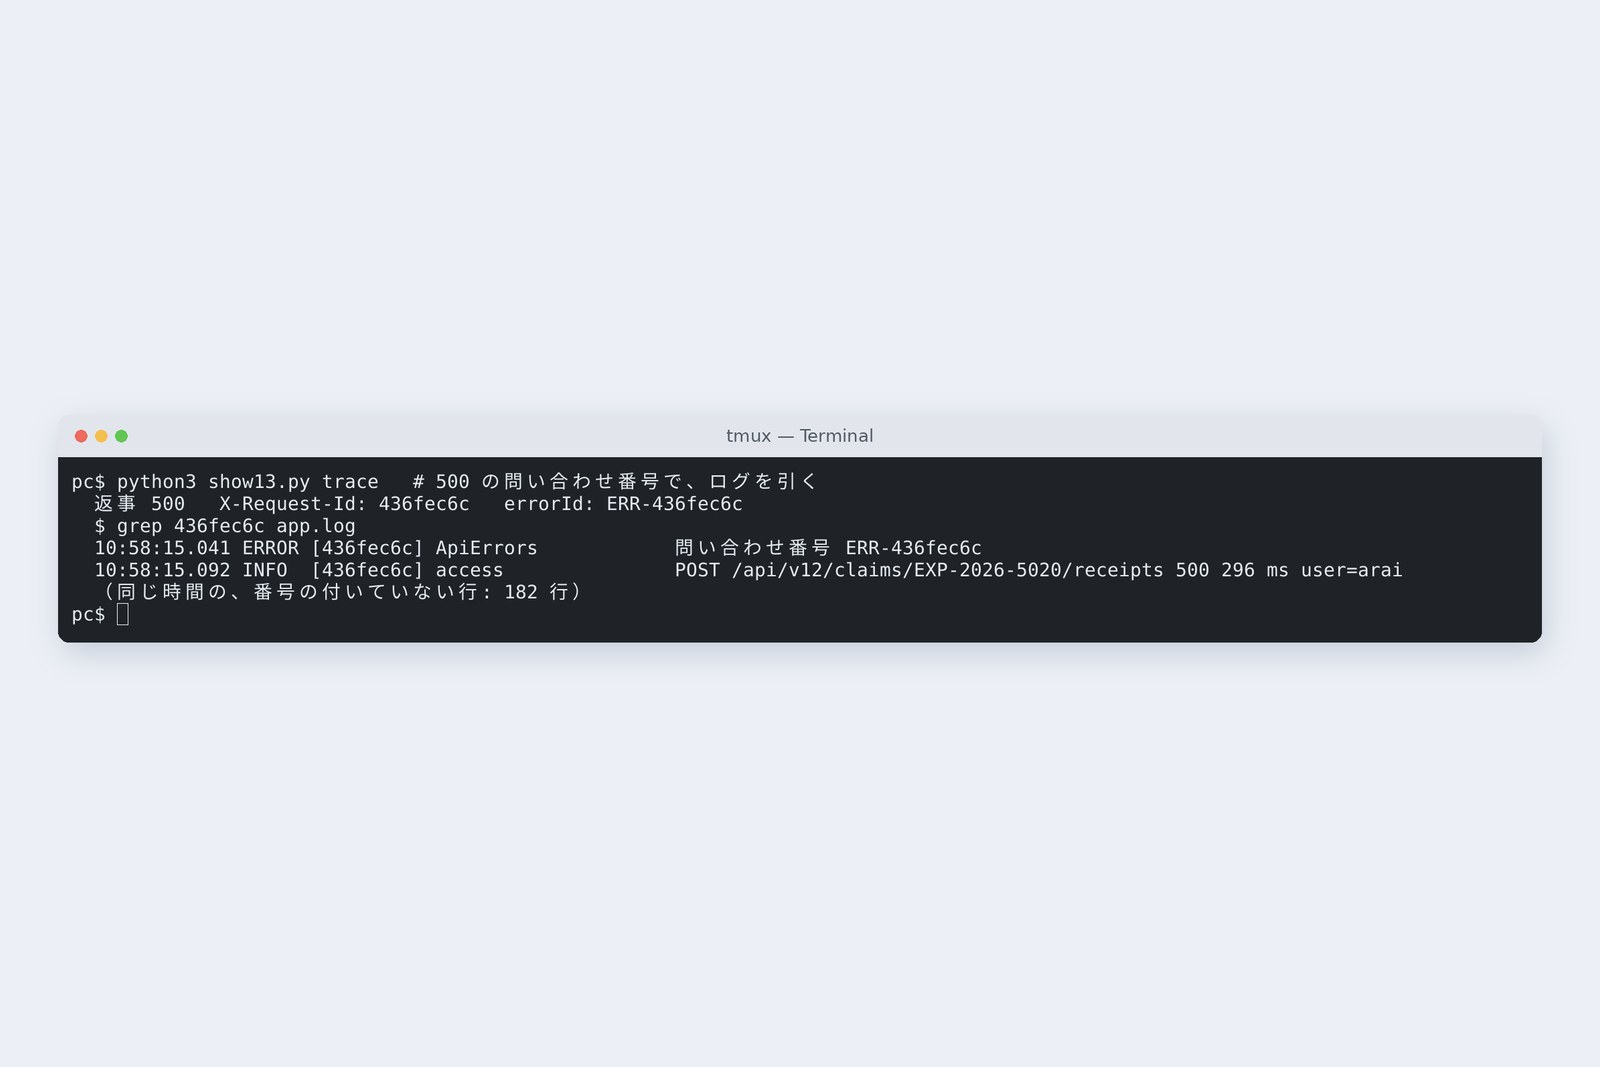
# 用 150 个字符名字的收据引发 500,按编号查日志
  HTTP 500   X-Request-Id: 23c165c8   errorId: ERR-23c165c8
$ grep 23c165c8 app.log
10:54:31.882 ERROR [23c165c8] ApiErrors            問い合わせ番号 ERR-23c165c8
10:54:31.927 INFO  [23c165c8] access               POST /api/v12/claims/EXP-2026-5020/receipts 500 245 ms user=arai
  (同一时间未带编号的行:182 行,是堆栈的后续行)
# 同样的事,用结构化日志(ECS 的 JSON)
  ERROR reqId=6be6d7be  問い合わせ番号 ERR-6be6d7beerror.stack_trace: 182 行
  INFO  reqId=6be6d7be  POST /api/v12/claims/EXP-2026-5020/receipts 500 264 ms user=…
  (未带编号的行:0 行)
日志一行的内容
只要用户说“显示了 ERR-23c165c8”,用这个编号 grep 一下,那个请求的行就都出来了。不过,堆栈的后续行(at …)不带编号。解决这一点的,就是下面的结构化日志。
结构化日志
Spring Boot 只要一行设置,就能用 JSON(ECS 等固定格式)写日志。一个事件一定是一行。
# logging.structured.format.console=ecs 时的 1 行(为便于阅读换了行)
{
  "@timestamp": "2026-10-31T01:54:41.576648739Z",
  "log": {
    "level": "INFO",
    "logger": "access"
  },
  "process": {
    "pid": 1766,
    "thread": {
      "name": "http-nio-8080-exec-6"
    }
  },
  "service": {
    "name": "expenses",
    "version": "0.0.1-SNAPSHOT",
    "node": {}
  },
  "message": "GET /api/v11/claims/EXP-2026-5001 200 58 ms user=arai",
  "user": "arai",
  "reqId": "465dac40",
  "ecs": {
    "version": "8.11"
  }
}
放进 MDC 的编号(reqId)和用户(user)直接成了字段。让刚才的 500 用 JSON 来写,堆栈被放进 error.stack_trace,未带编号的行变成 0 行。人眼读起来不太方便,但对收集日志的工具(搜索和图表)来说更合适。
看数字
日志是“一件一件的事”。“现在整体怎么样”,要看数字。Actuator 不用写任何代码,就按窗口、按回复统计次数和时间。
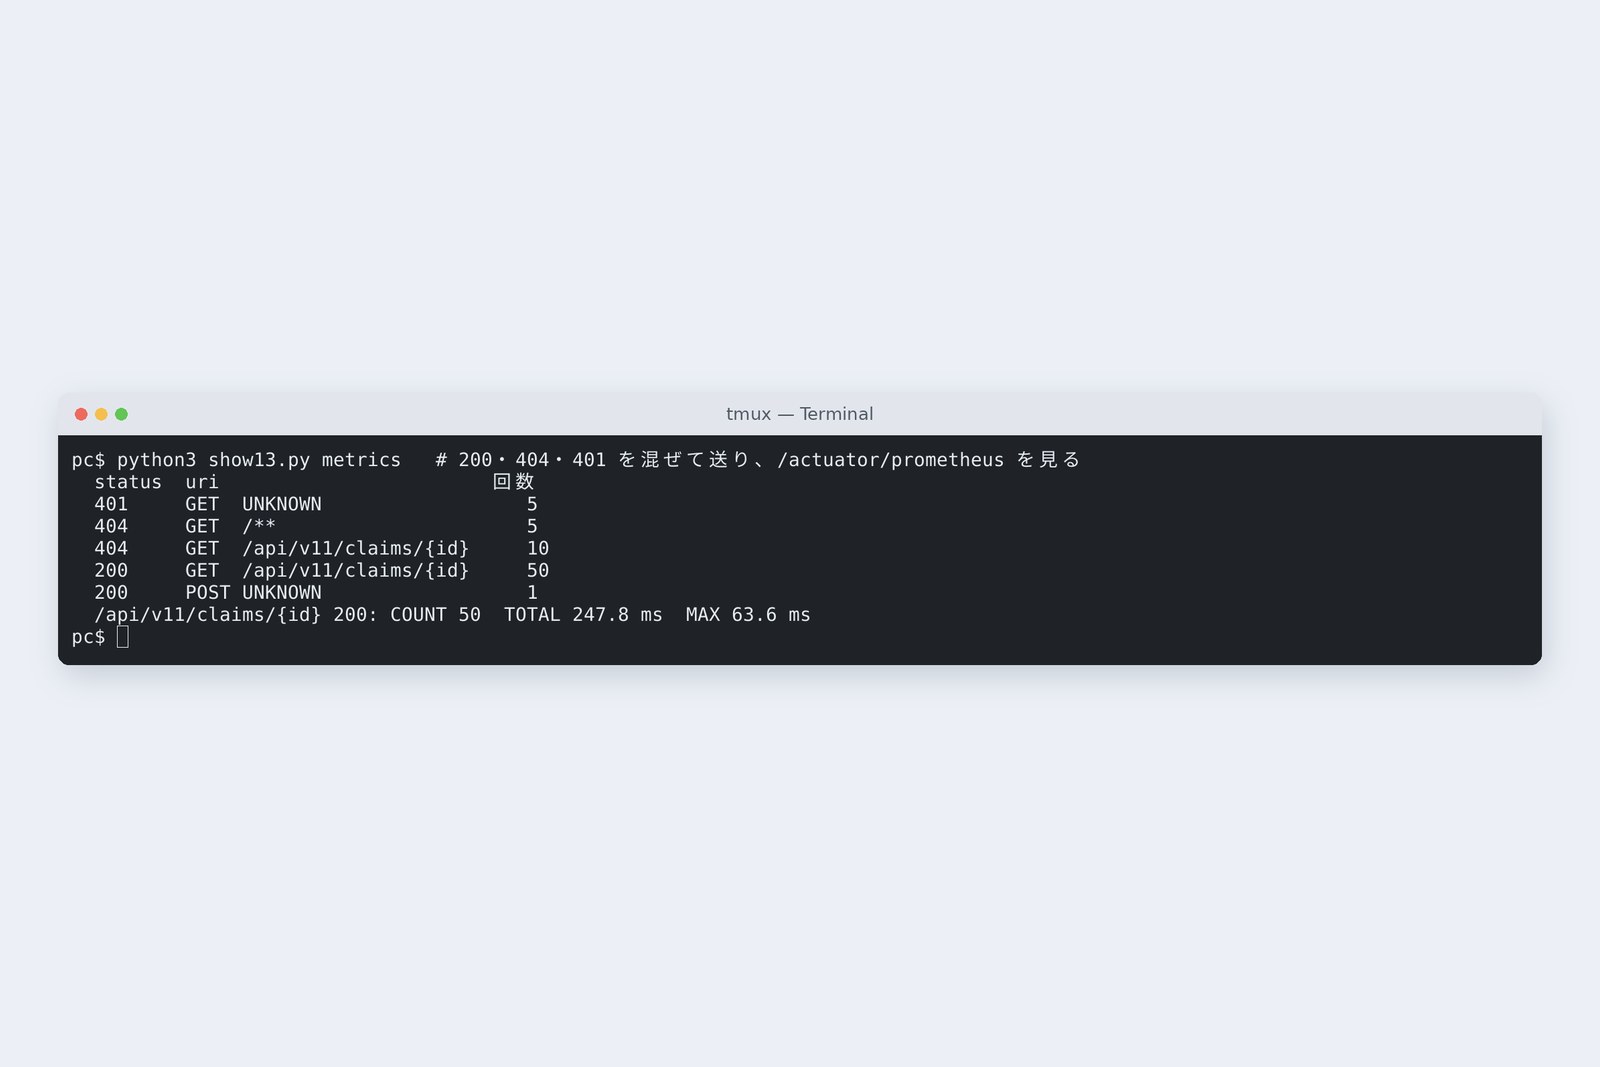
# 200 发 50 次,用别人的申请得到 404 10 次,未登录 5 次,/favicon.ico 5 次
  http_server_requests_seconds_count{method="GET",status="401",uri="UNKNOWN"} 5
  http_server_requests_seconds_count{method="GET",status="404",uri="/**"} 5
  http_server_requests_seconds_count{method="GET",status="404",uri="/api/v11/claims/{id}"} 10
  http_server_requests_seconds_count{method="GET",status="200",uri="/api/v11/claims/{id}"} 50
  http_server_requests_seconds_count{method="POST",status="200",uri="UNKNOWN"} 1
# GET /actuator/metrics/http.server.requests?tag=uri:/api/v11/claims/{id}&tag=status:200
  COUNT 50   TOTAL_TIME 0.312 s   MAX 0.060 s
URL 按 {id} 的模式统计,不会按受理编号分散开。未登录的 401 被门卫拦下,所以 uri 是 UNKNOWN;不存在 URL 的 404 是 /**。修改之前,这里本该排着 500。
数字也能按时间来看。同时发送 12 件第 9 讲的“在事务里等 1 秒”,每 0.25 秒查看一次连接池。
# 同时发 12 件第 9 讲的“在里面等”,每 0.25 秒查看连接池(秒・使用中・等待)
   0.11  0 0    0.37  0 0    0.63  0 0    0.90 10 2    1.16 10 2
   1.43 10 2    1.70 10 2    1.96 10 1    2.22 10 1    2.48 10 1
   2.74 10 1    3.00 10 0    3.26 10 0    3.52 10 0    3.78 10 0
   4.04  9 0    4.30  9 0    4.56  9 0    4.82  9 0    5.08  7 0
   5.35  7 0    5.61  7 0    5.87  7 0    6.13  6 0    6.39  6 0
   6.65  6 0    6.90  6 0    7.16  5 0    7.42  5 0    7.68  5 0
   7.94  5 0    8.20  4 0    8.46  4 0    8.72  4 0    8.97  4 0
   9.24  3 0    9.49  3 0    9.75  3 0   10.01  3 0   10.26  2 0
  10.52  2 0   10.78  2 0   11.04  2 0   11.30  1 0   11.56  1 0
  11.81  1 0   12.07  1 0
连接池(实测)
使用中很快贴在上限 10 条,有 2 件在等连接。第 9 讲是从“第 12 件要 12 秒”的结果推测的,看数字就能当场知道。Actuator 的窗口开在与业务窗口不同的端口(8081),公开的也只有 health・metrics・prometheus。
数据库停了的话
最后,试着停掉练习用的数据库。先打开申请,再看健康检查(/actuator/health)。
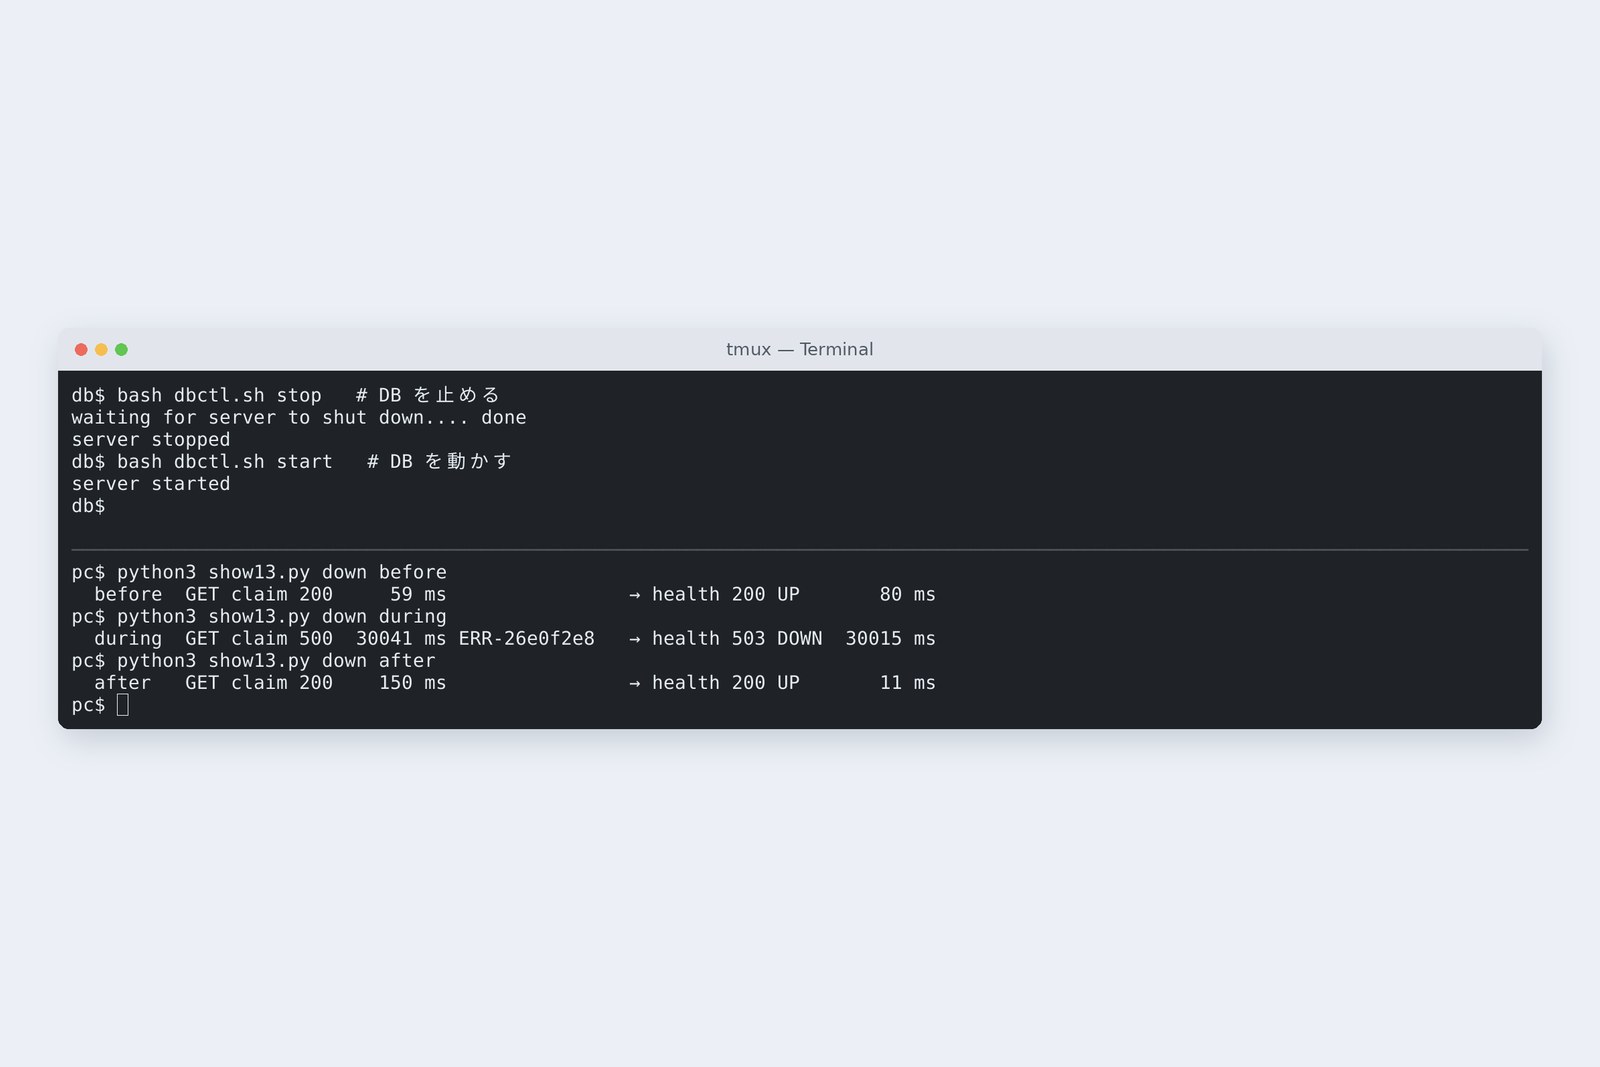
# 停止数据库之前・停止期间・重新启动后(先打开申请,再做健康检查)
  停止前GET claim 200     90 ms                health 200 UP       74 ms
  停止期间GET claim 500  30178 ms ERR-d8bb10ab   health 503 DOWN  30024 ms
  重新启动后GET claim 200   2793 ms                health 200 UP       13 ms
# 停止期间 1 个 GET 增加的日志
  共 678 行(ERROR 1 行,at 行 631 行,WARN 14 行)
  Caused by: java.sql.SQLTransientConnectionException: HikariPool-1 - Connection is not available, request timed out after 30001ms (total=0, a…
数据库停止期间的等待(实测)
只是打开申请的 GET,等了 30 秒才返回 500。因为连接池无法建立新连接,一直等到 HikariCP 的 connectionTimeout(默认 30 秒)。健康检查也同样花了 30 秒才 DOWN。而为了这 1 件,日志增加了 678 行。
与其让用户等 30 秒,不如早点放弃、返回“现在无法使用”更友好。可以缩短 spring.datasource.hikari.connection-timeout,给健康检查加上时间上限等。重新启动数据库后,第一个 GET 因重新连接用了 2.8 秒,健康检查 13 ms 就回到了 UP。
监视什么
| 监视对象 | 在哪里看 | 这一讲的例子 |
|---|---|---|
| 5xx 的比例 | http.server.requests(status) | 不存在 URL 的 500,数据库停止时的 500 |
| 回复时间(较慢的那几%) | http.server.requests(时间) | 数据库停了就是 30 秒 |
| 连接的等待 | hikaricp.connections.pending | 在里面等的 12 件时为 2 |
| 健康检查 | /actuator/health | 数据库停了就 DOWN(不过是 30 秒后) |
| ERROR 的行数 | 日志 | favicon 的 500 一直在增加 |
日志讲一件事,数字看整体,健康检查看是否活着。日志只写编号和结果,不写内容和秘密。而且,读日志的习惯比任何工具都先需要。
在自己的电脑上验证
| 想试的事 | 写法 |
|---|---|
| 集中一个请求的行 | grep 23c165c8 app.log |
| 出了多少个 ERROR | grep -c ' ERROR ' app.log |
| 找出不该写进日志的东西 | grep -c -e '{bcrypt}' -e 'Parameters:' app.log |
| 按窗口统计次数 | curl -s localhost:8081/actuator/prometheus | grep http_server_requests_seconds_count |
| 改成 JSON 日志 | logging.structured.format.console=ecs |
先把自己应用一天的日志原样读一遍吧。有几个 ERROR,其中真正需要处理的有几个。光是这样,这一讲的一半就完成了。
结 — 一页总结与下一讲
- 日志只写服务器看到的事。12 MB 的照片只有“返回了 413”一行。
- 不存在的 URL 是 500 加 59 行堆栈。不读就发现不了。
- 保持 DEBUG,1 个 GET 写 5 行,还带着散列和 SQL 的值。生产用 INFO,每件 1 行。
- 给请求编号,放进每一行和错误回复里。
- 一件事看日志,整体看数字(Actuator),是否活着看健康检查。
- 数据库停了,等 30 秒才 500。等待时间要自己决定。
新井favicon 的 500,原来从第 7 讲就一直在……
古井已经修好了。那么,下个月有人改写处理员时,你能保证它不会又变回 500 吗?下一讲是测试。让机器替我们记住修好的东西。
参考
- Spring Boot — Logging(Structured Logging)
- Spring Boot — Actuator Endpoints(health)
- Spring Boot — Metrics(http.server.requests、hikaricp)
- SLF4J — User Manual(MDC)
- Elastic Common Schema(ECS)
- OWASP — Logging Cheat Sheet
记录是笔者于 2026 年 10 月 31 日在云端 Linux(Ubuntu 24.04,内核 6.18)上,用 Spring Boot 4.1.2(Spring Framework 7.0.10、Spring Security 7.1.2、Actuator、Micrometer 的 Prometheus 输出、HikariCP 7.0.2、MyBatis 3.5.19)、OpenJDK 25.0.4、PostgreSQL 16.15 取得的。申请服务器与数据库服务器是在一台机器里建的不同网络空间(network namespace),往返约 0.04 ms。日志写入文件后统计。停止的数据库是笔者练习用的。散列只截取了前半部分。文中的数字和输出,都是从当时命令输出里读到的实际值(只有一天 10 万件的计算,是由实测的每件大小推算的)。登场人物均为虚构。
古法后端入门 第13讲 — 日志与监控 / 2026.10