Old-School Backend / 2026 ・ No.15
いにしえのバックエンド入門
第15回(最終回) 動かす ── 申請のアプリを、自分の PC の外へ
公開
この連載のアプリは、ずっと筆者の練習用の部屋(ネットワーク空間と練習用 DB)の中で動いてきました。最終回は、そこから外へ出します。
まず第14回の jar を、まっさらな DB で動かしてみます。DB の形をソースに置き(Flyway)、Docker の像に入れ、DB・アプリ・nginx の3つを compose で並べます。そのうえで、どれだけさばけるか、仮想スレッドで何が変わるか、止めるときと小さな箱で何が起きるかを測ります。最後に全15回をふりかえります。
練習の部屋の外で
新井テストも 107 件ありますし、どこでも動きますよね。
古井まっさらな DB で試そう。
全15回の路線図(いまここ:第15回)
# 第14回の jar の中の設定(unzip -p app.jar BOOT-INF/classes/application.properties)
  spring.datasource.url=jdbc:postgresql://db.internal:5432/expenses
  spring.datasource.password=practice
  spring.sql.init.mode=always
  demo.store=/home/claude/be13/store
# Docker で空の PostgreSQL 16 を立て、接続先だけ変えて第14回の jar を動かす
  Started ExpensesApplication in 6.051 seconds
  できた表expense   (schema.sql の1つだけ)
  GET  /api/expenses                 200  []
  GET  /api/v10/claims/EXP-2026-0012 500   ← column "applicant" does not exist
  POST /api/login                    401   ← relation "app_user" does not exist
jar の中に、練習用 DB の場所(db.internal)、パスワード、ファイルの置き場所(筆者の作業フォルダ)が入っていました。接続先だけ変えて動かすと、アプリは 6 秒で起動します。でも DB にできた表は、第1回の schema.sql の1つだけ。申請を開くと 500、ログインは 401 でした。
401 は「パスワードがちがう」と同じ返事ですが、本当の原因は利用者の表がないことです(ログには書いてありました)。起動した、テストは緑、でも外では動かない。第14回のテストが通ったのは、テスト用の DB の形を別に持っていたからです。
- 形 ── DB の形をソースに(Flyway)。像に入れ、compose で並べる(実測)
- 入口 ── nginx の設定ひとつで、クッキー・413・502 が変わる(実測)
- さばく量 ── 仮想スレッドで伸びる仕事、伸びない仕事(実測)
- 止まり方 ── 止める猶予と、512 MB の箱でのヒープ(実測)
DB の形をソースに置く
第4回から、DB の形は回ごとの SQL を手で流して変えてきました。これを、番号つきのファイルとしてソースに置き、アプリが起動するときにまだ当てていないものだけを順に当てるのが Flyway です。Spring Boot は、Flyway が入っていれば起動のときに自動で動かします。
# src/main/resources/db/migration/
  V1__baseline.sql                 第1〜13回の形(26 文、pg_dump -s から)
  V2__expense_applicant_index.sql  create index … on expense (applicant);
# ① 空の DB で起動
  Migrating schema "public" to version "1 - baseline"
  Successfully applied 1 migration … now at version v1 (execution time 00:00.039s)
# ② もう一度起動
  Schema "public" is up to date. No migration necessary.
# ③ 当てたあとの V1 に、説明を1行足して起動
  Migration checksum mismatch for migration version 1
  -> Applied to database : -1908829391
  -> Resolved locally    : -853976515
  → アプリは起動せずに終了(Exited (1))
# ④ V1 を戻し、V2 を足して起動
  Migrating schema "public" to version "2 - expense applicant index"   (00:00.014s)
  flyway_schema_history:  1 | baseline | 39 ms     2 | expense applicant index | 14 ms
当てた記録は、DB の中の flyway_schema_history に残ります。2回目の起動では何もしません。③では、当てたあとの V1 に説明を1行足しただけで、アプリが起動しなくなりました。ファイルの指紋(checksum)が、当てたときと変わったからです。当てたファイルは直さない。変えたいときは次の番号を足す。V2 は 14 ms で当たりました。
第14回のテストも、テスト用の DDL をやめて同じ V1・V2 を使うようにしました。107 件はそのまま通りました。テストと本番が、同じ形から始まります。
像に入れる
次は Docker の像(イメージ)です。Java の入った像(eclipse-temurin:25-jre)に jar を入れれば動きますが、少しだけ手を加えました。
# 層に分けて入れ、root ではない利用者で動かす
FROM eclipse-temurin:25-jre AS build
WORKDIR /w
COPY app.jar .
RUN java -Djarmode=tools -jar app.jar extract --layers --launcher --destination out

FROM eclipse-temurin:25-jre
RUN useradd --system --uid 10001 app && mkdir -p /data/store/receipts && chown -R app /data
WORKDIR /app
COPY --from=build /w/out/dependencies/ ./
COPY --from=build /w/out/spring-boot-loader/ ./
COPY --from=build /w/out/snapshot-dependencies/ ./
COPY --from=build /w/out/application/ ./
USER app
ENV DEMO_STORE=/data/store
EXPOSE 8080 8081
ENTRYPOINT ["java", "org.springframework.boot.loader.launch.JarLauncher"]
# 像の大きさ(docker image ls)
  eclipse-temurin:25-jre  480MB   (Ubuntu 26.04 と Java 25.0.5)
  expenses:naive          543MB   (jar を1つ入れただけ)
  expenses:15             544MB   (層に分けた)
# 窓口のコードを1行変えて、像を作りなおしたとき変わった層
  expenses:naive   1 層35.7MB   COPY app.jar /app.jar
  expenses:15      1 層451kB    COPY /w/out/application/   (ライブラリの 35.6MB は変わらず)
# だれとして動くか(docker run --entrypoint id)
  expenses:naive   uid=0(root) gid=0(root) groups=0(root)
  expenses:15      uid=10001(app) gid=999(app) groups=999(app)
# パスワードはどこにあるか
  jar の設定にある password の行第14回 1 → 第15回 0
  像の履歴(docker history)に出る練習用パスワード0
  → 起動するときに、compose が .env から環境変数で渡す
大きさはどちらも 540 MB ほどで、ほとんどは土台の Ubuntu と Java です。ちがいは作りなおしたときに出ます。jar をまるごと入れた像は、1行直すたびに 35.7 MB の層が入れかわります。Spring Boot の jarmode=tools で層に分けると、変わるのは自分のコードの 451 kB だけ。ライブラリの層はそのまま使い回せるので、配る量も待ち時間も減ります。
もう1つ、素直な像は root で動いていました。第12回のように、アプリが思わぬ場所にファイルを書けてしまったとき、root ならコンテナの中のどこでも書けます。専用の利用者を作って、それで動かします。パスワードは jar からも像からも消し、起動するときに環境変数で渡します。
3つを並べる
DB・アプリ・nginx の3つを、compose.yaml に書きます。アプリの部分はこうです。
services:
  db:  …
  app:
    build: .
    image: expenses:15
    environment:
      SPRING_DATASOURCE_URL: jdbc:postgresql://db:5432/expenses
      SPRING_DATASOURCE_USERNAME: app
      SPRING_DATASOURCE_PASSWORD: ${DB_PASSWORD}
      JAVA_TOOL_OPTIONS: ${JAVA_OPTS:-}
      SPRING_THREADS_VIRTUAL_ENABLED: ${VIRTUAL:-false}
      SERVER_FORWARD_HEADERS_STRATEGY: ${FORWARD:-native}
      DEMO_SEED: ${SEED:-false}
    volumes:
      - store:/data/store
    restart: ${RESTART:-no}  # 落ちたら起こしなおす
    stop_grace_period: 40s  # Spring の待ち(既定 30 秒)より長く。docker の既定は 10 秒
    depends_on:
      db:
        condition: service_healthy
    healthcheck:  # 像に curl がないので、bash で 8081 の health を聞く
      test: ["CMD", "bash", "-c", "exec 3<>/dev/tcp/localhost/8081 && printf 'GET /actuator/health HTTP/1.0\\r\\n\\r\\n' >&3 && grep -q '\"status\":\"UP\"' <&3"]
      interval: 5s
      timeout: 3s
      retries: 3
      start_period: 60s
  web:  …
Java の像には curl がないので、健康診断は bash で 8081 番に直接聞きます(第13回の /actuator/health)。depends_on に service_healthy と書くと、DB が健康になってからアプリ、アプリが健康になってから nginx の順に起動します。パスワードは compose と同じ場所の .env から渡し、像にも Git にも入れません。
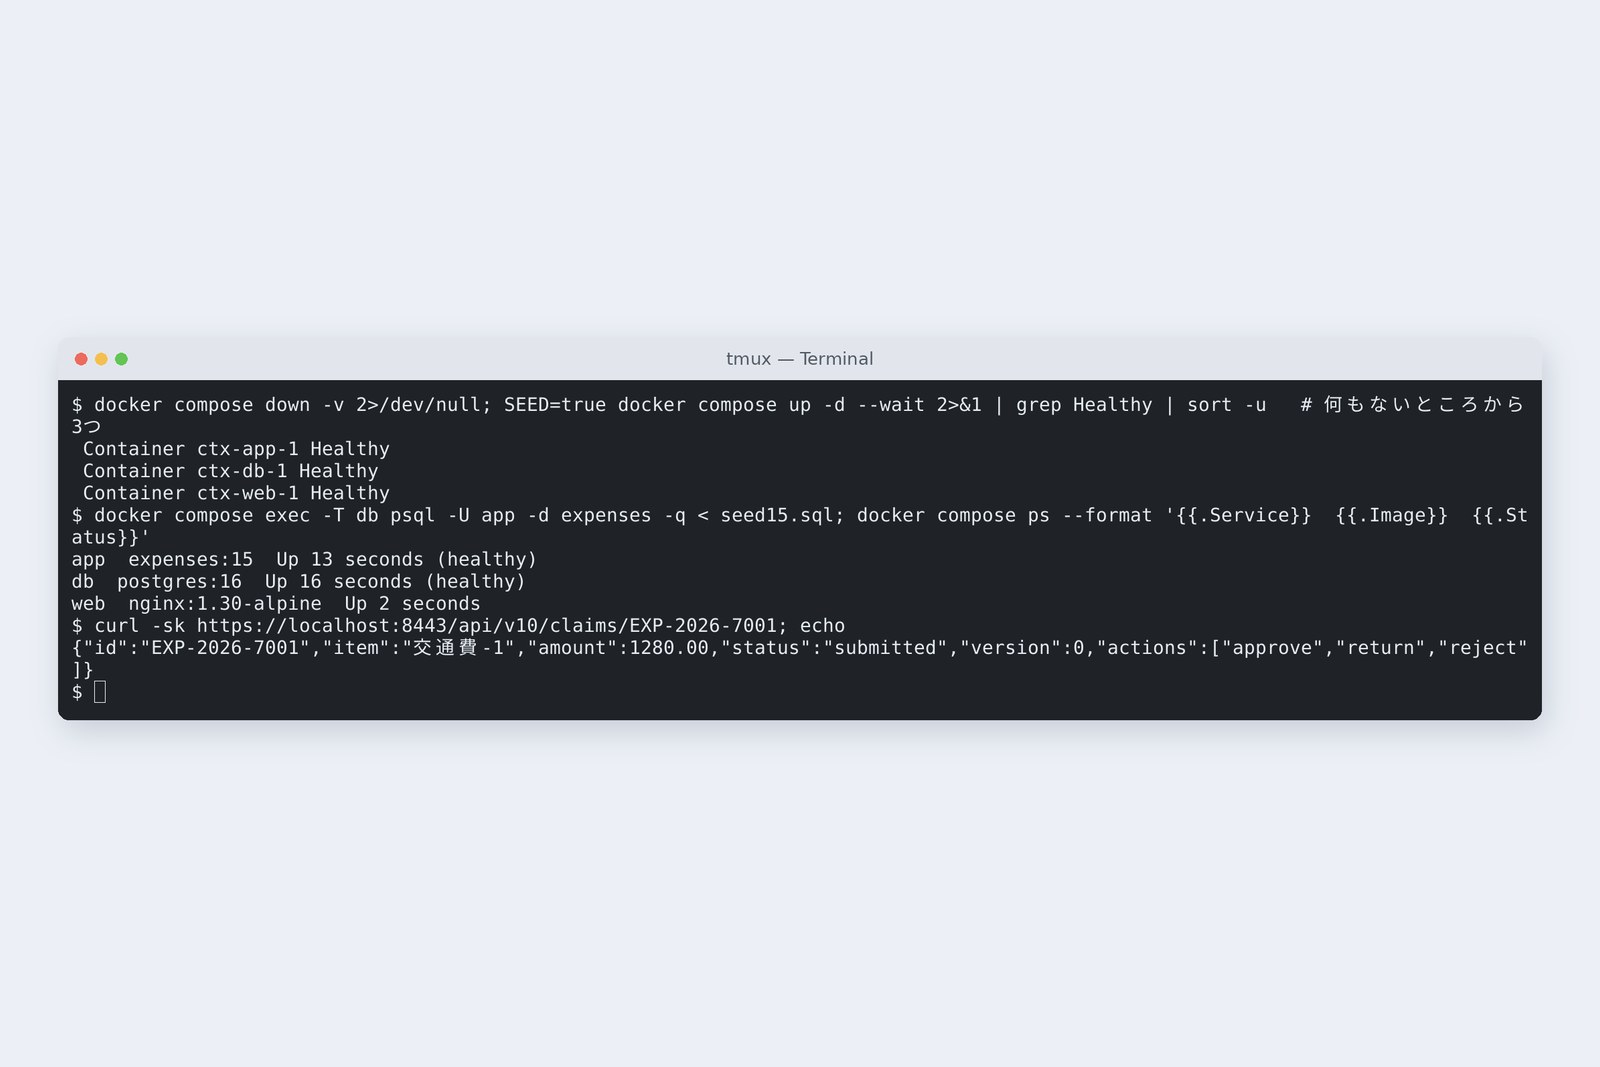
# 何もないところ(DB の中身も空)から docker compose up -d --wait
  db   Healthy → app   Healthy → web   Healthy        11.1 s
  アプリの中Flyway V1 39 ms,  Started ExpensesApplication in 5.457 seconds
  GET https://localhost:8443/api/v10/claims/EXP-2026-7001   200
できあがった形
何もないところから 11 秒で、Flyway が形を作り、https で申請が開けました。別の PC でも、この compose.yaml と .env があれば同じ形で立ち上がります。
nginx を前に置く
利用者とアプリの間には、nginx を置きます。https(TLS)を受け持ち、アプリは中の網からだけ見えるようにします。まずは「アプリへ渡すだけ」の素直な設定と、本番向けの設定を比べました(証明書は練習用の自己署名です)。
# lab15.py nginx:ログインして、領収書を2枚送り、http と一覧を見る
                                素直な設定本番向け
  ログインのクッキーHttpOnly                      Secure; HttpOnly
  3.54 MB の写真413 text/html                 200 application/json
  12.05 MB の写真413 text/html                 413 application/problem+json
  http(80 番)で開く200                           301 → https
  返事の Servernginx/1.30.6                  nginx
  一覧 100 件の大きさ10,293 B                      701 B (gzip)
# 素直な設定の 413 の中身(アプリではなく nginx の HTML)
  <html> <head><title>413 Request Entity Too Large</title></head> <body> <center><h1>413 Request E…
# 本番向けの nginx でも、アプリの forward-headers-strategy が none だと
  JSESSIONID=…; Path=/; HttpOnly   ← Secure が付かない
# 本番向け:http は https へ、どこから来たかをアプリに伝え、大きさの上限をアプリと合わせる
upstream app {                                # proxy_pass に名前を直接書くと、接続を使い回さなかった(実測)
    server app:8080;
    keepalive 32;                             # 接続を使い回す。1.29.7 からは upstream の既定(明記しておく)
}

server {
    listen 80;
    server_tokens off;
    return 301 https://$host:8443$request_uri;
}

server {
    listen 443 ssl;
    server_tokens off;                        # 返事に nginx の版を書かない
    ssl_certificate     /etc/nginx/certs/cert.pem;
    ssl_certificate_key /etc/nginx/certs/key.pem;

    client_max_body_size 10m;                 # アプリの上限(10MB)と合わせる。既定は 1m
    error_page 413 = @too_large;              # 断るときも、アプリと同じ JSON の形で

    location @too_large {
        default_type application/problem+json;
        return 413 '{"type":"https://expenses.example/problems/too-large","title":"ファイルが大きすぎます","status":413}';
    }

    location /api/ {
        proxy_pass http://app;
        proxy_http_version 1.1;                # この2行も 1.29.7 からは既定。古い nginx では必要
        proxy_set_header Connection "";
        proxy_set_header Host $host;
        proxy_set_header X-Forwarded-For $proxy_add_x_forwarded_for;
        proxy_set_header X-Forwarded-Proto $scheme;
        proxy_set_header X-Forwarded-Port 8443;
        gzip on;
        gzip_types application/json application/problem+json;
    }
}
素直な設定では、スマホの写真 3.54 MB が nginx の 413(HTML)で断られました。nginx の既定の上限は 1 MB で、第12回でアプリを 10 MB にした話は、ここで止まっていたのです。画面は JSON を待っているのに HTML が返ります。本番向けでは上限をアプリと同じ 10 MB にし、断るときもアプリと同じ JSON の形にしました。
ログインのクッキーに Secure(https のときだけ送る)が付かなかったのは、アプリから見ると nginx からの頼みごとが http だったからです。nginx が X-Forwarded-Proto: https を付け、アプリが server.forward-headers-strategy=native でそれを信じると、付きました。どちらか片方だけでは付きません(実測)。ほかに、http を https へ、一覧の JSON を gzip で 10,293 → 701 バイト、返事から nginx の版を消しました。
どれだけさばけるか
wrk で、申請1件を開く GET を 10 秒ずつ送りました。この PC は CPU 2 つで、wrk・nginx・アプリ・DB が同じ CPU を取り合います。数字は「この箱の中で比べるため」のものです。
# GET /api/v10/claims/EXP-2026-7001 を wrk で 10 秒(3回の範囲、1秒あたりの件数)
  同時アプリに直接nginx(素直)nginx(使い回し)
  1       1765〜1909/s374〜945/s1164〜1197/s
  10      2565〜2902/s794〜1190/s1728〜1822/s
  50      2562〜2886/s657〜1199/s1685〜1885/s
  200     2679〜2998/s627〜1109/s (502 209)1734〜1923/s
  中央の待ち時間(同時 50)18〜20 / 38〜69 / 27〜29 ms
# 素直な nginx の中(同時 200 のあと)
  TIME_WAIT 20159
  [crit] connect() to 172.20.0.3:8080 failed (99: Address not available)   × 253   → 502
# 確かめ:nginx 1.30.6 で、何を書けば使い回すか(同時 200・10 秒のあと、アプリへの接続)
  proxy_pass http://app:8080;       TIME_WAIT 5472
  upstream ブロックだけESTABLISHED 37   TIME_WAIT 354
  upstream + keepalive 32 などESTABLISHED 25   TIME_WAIT 1138
アプリに直接だと 1 秒 2,500〜3,000 件。ところが素直な nginx を通すと、半分以下に落ち、同時 200 では 502 が混じりました。nginx の中を見ると、アプリへの接続が TIME_WAIT(閉じたあとの待ち)で 2 万本。頼みごとのたびにアプリへ新しく接続し、使える番号(ポート)を使い切っていたのです。
upstream のブロックを書くと、接続が使い回され、502 は消えて 1 秒 1,700〜1,900 件になりました。nginx 1.29.7 から、upstream の接続の使い回しは既定になっています。ただ今回の 1.30.6 でも、proxy_pass にアプリの名前を直接書いた形では使い回されませんでした。既定が変わっても、自分の設定でそうなっているかは測って確かめる。
待つ仕事と仮想スレッド
申請のアプリには、ほかの会社の API(交通費の運賃の確認や、経理のシステムへの連絡など)を待つ仕事がよくあります。それを「200 ms 眠る」で置きかえた窓口を作りました。
/** 第15回:外の仕事(ほかの会社の API など)を待つつもりで眠る。トランザクションの外か、中か */
@Service
public class WaitService {
    private final ClaimFlowService flow;

    public WaitService(ClaimFlowService flow) {
        this.flow = flow;
    }

    public ClaimState waitOutside(String id, long ms) {  // 待ってから、短く DB を読む
        sleep(ms);
        return flow.find(id);
    }

    @Transactional  // DB の接続を持ったまま待つ
    public ClaimState waitInside(String id, long ms) {
        ClaimState c = flow.find(id);
        sleep(ms);
        return c;
    }

    static void sleep(long ms) {
        try {
            Thread.sleep(ms);
        } catch (InterruptedException e) {
            Thread.currentThread().interrupt();
        }
    }
}
Tomcat のふつうのスレッド(platform)は、上限が 200 本です。Java 21 からの仮想スレッドは、待っている間はスレッドを手放すので、本数の上限を気にしなくてよくなります。Spring Boot では spring.threads.virtual.enabled=true の1行です。
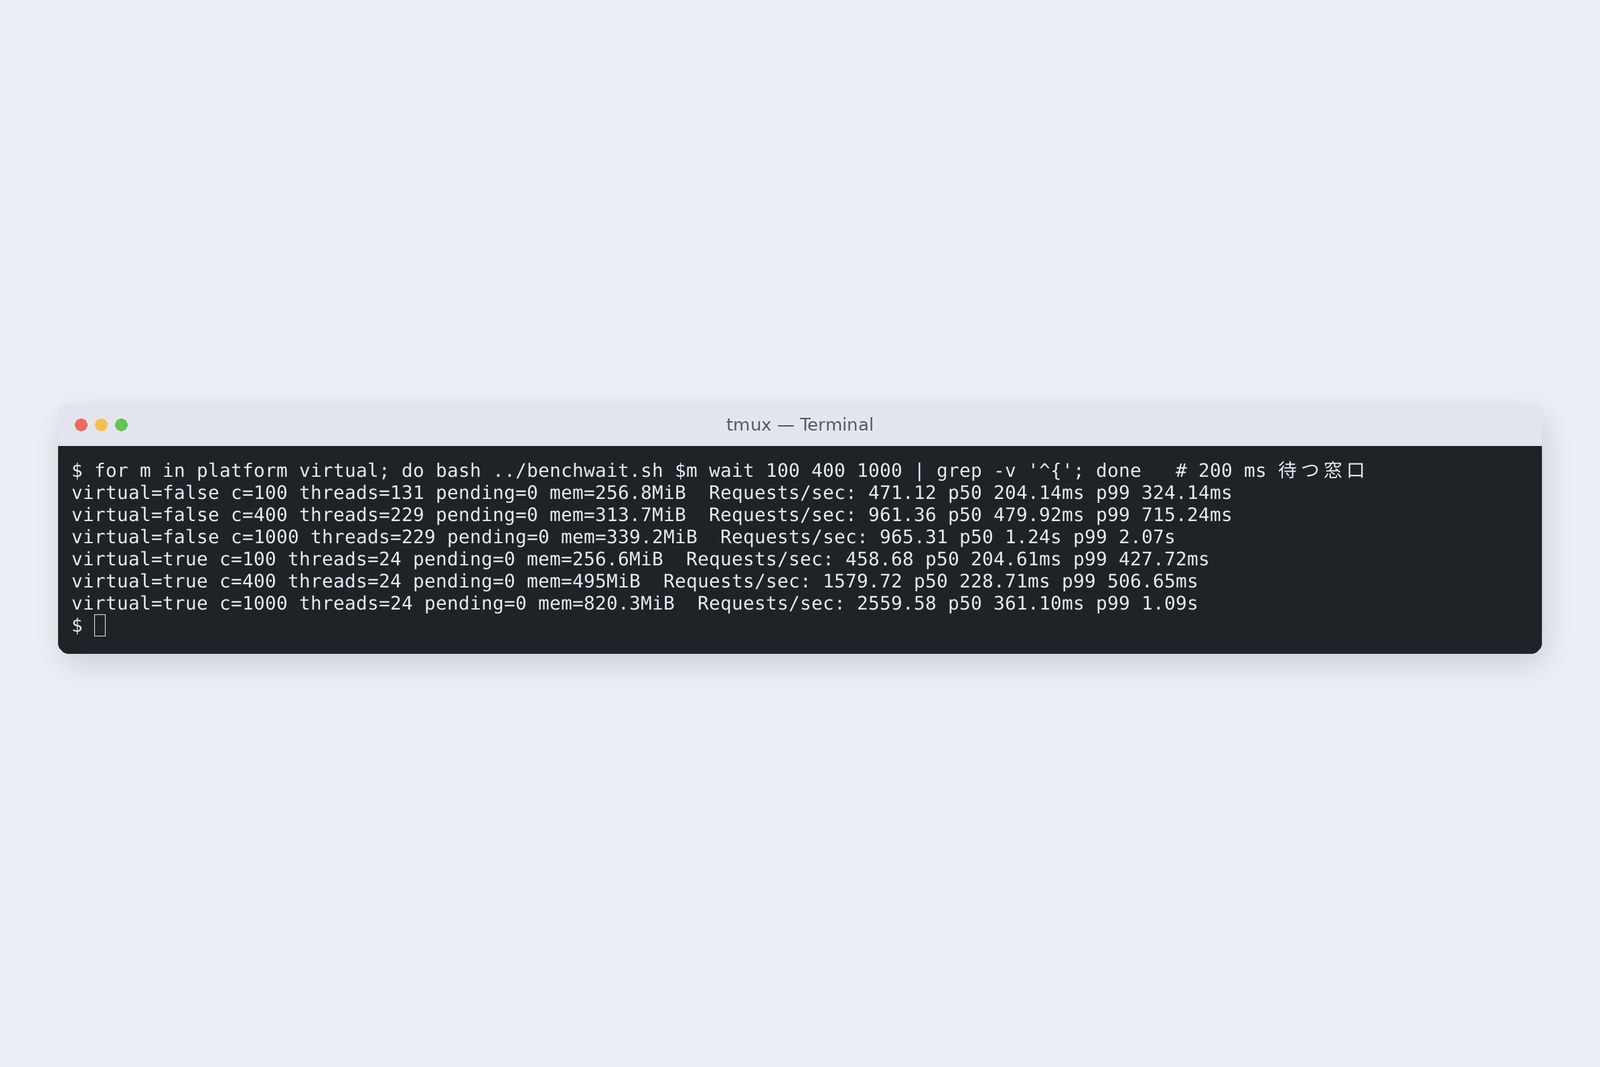
# 200 ms 待ってから DB を読む窓口。同時 100 → 400 → 1000 の順に 15 秒ずつ(3回の範囲)
                            1秒あたり中央の待ちスレッド
  platform c=100            471〜475204 ms        131
  platform c=400            961〜967468〜486 ms229
  platform c=1000           959〜9651240〜1260 ms 228〜229
  virtual  c=100            459〜460203〜205 ms24
  virtual  c=400            1516〜1689220〜238 ms24
  virtual  c=1000           2452〜2760347〜376 ms24
# 起動してすぐ(温まる前)に、仮想スレッドで同時 1000 だけを送ると
  1196 / 1060 / 1042 / 930 /s   (同じ JVM の2回目は 1509 /s)
待つ窓口の 1 秒あたりの件数(実測)
ふつうのスレッドは、200 本 ÷ 0.2 秒 = 1 秒 1,000 件で頭打ちになり、同時 1000 では中央の待ちが 1.24 秒に伸びました。仮想スレッドは同時 1000 で 1 秒 2,450〜2,760 件、中央の待ちは 0.35 秒ほど。本物の OS のスレッドは 24 本のままでした。
ひとつ注意があります。起動してすぐに同時 1000 だけを送ると、仮想スレッドでも 1 秒 930〜1,200 件でした。同じ JVM で2回目に送ると 1,509 件、軽い負荷で温めたあとは 2,500 件前後。JVM は温まってから速くなる(第1回の「最初の1件は遅い」と同じ話です)。測るときは、温め方も書いておきます。
仮想スレッドでも増えないもの
同じ 200 ms を、今度はトランザクションの中で待ちました。第9回の「トランザクションの中で通知を待つ」と同じ形です。
# トランザクションの中で 200 ms 待つ窓口(15 秒)
                        1秒あたり中央の待ち接続待ちスレッド
  platform c=100        49.0        2.02 s        90                130
  platform c=400        42.7        5.81 s        191               229
  virtual  c=100        48.4        2.03 s        90                24
  virtual  c=400        41.7        7.71 s        392               24
  接続の池は 10 本 × 1秒に 5 回(200 ms)= 50 件/秒が上限
どちらのスレッドでも 1 秒 49 件ほど。DB の接続の池は 10 本で、1本を 200 ms 持ったままなら、1 秒に 50 件が上限です。仮想スレッドにすると、接続を待つ列(pending)が 392 まで伸びただけでした。仮想スレッドが増やすのは「待てる数」で、DB の接続ではない。外の仕事はトランザクションの外で待つ、という第9回の結論は、仮想スレッドでも変わりません。
なお、仮想スレッドが synchronized の中で OS のスレッドを手放せない問題は、JDK 24 で直されています(JEP 491)。この回の Java は 25 です。
止めるとき、小さな箱
新しい版に入れかえるときは、古いアプリを止めます。処理中の 20 件があるときに止めてみました。
# 処理中の 20 件があるときに docker compose stop app
  1件 3 秒、猶予 10 秒(既定)止まるまで 2.9 s200 × 20
  1件 15 秒、猶予 10 秒(既定)止まるまで 10.4 sConnectionError × 20   Exited (137)
  1件 15 秒、猶予 40 秒止まるまで 15.0 s200 × 20                 Exited (143)
  ログCommencing graceful shutdown. Waiting for active requests to complete
Spring Boot は止めるとき、処理中の頼みごとが終わるのを待ちます(既定で最大 30 秒)。ところが docker の既定の猶予は 10 秒で、それを過ぎると強制終了(137)。15 秒かかる頼みごとは 20 件とも切れました。compose で猶予を 40 秒にすると、20 件とも 200 で終わってから止まりました。止める側と止められる側の待ち時間をそろえる。
次に、箱の大きさです。クラウドでは、メモリと CPU を決めた箱でアプリを動かします。
# 同じ像で、箱の大きさだけ変えて java -XX:+PrintFlagsFinal -XshowSettings:system
  箱CPU   ヒープの上限
  制限なし(この PC は 8 GB・2 CPU)2     2,008 MB
  --memory=512m --cpus=1                  1     128 MB   (25%)
    + -XX:MaxRAMPercentage=75             1     384 MB
JVM は箱の大きさを読み、ヒープを既定でその 25% にします。512 MB の箱なら 128 MB。この箱で、仮想スレッドに同時 1000 を送りました。
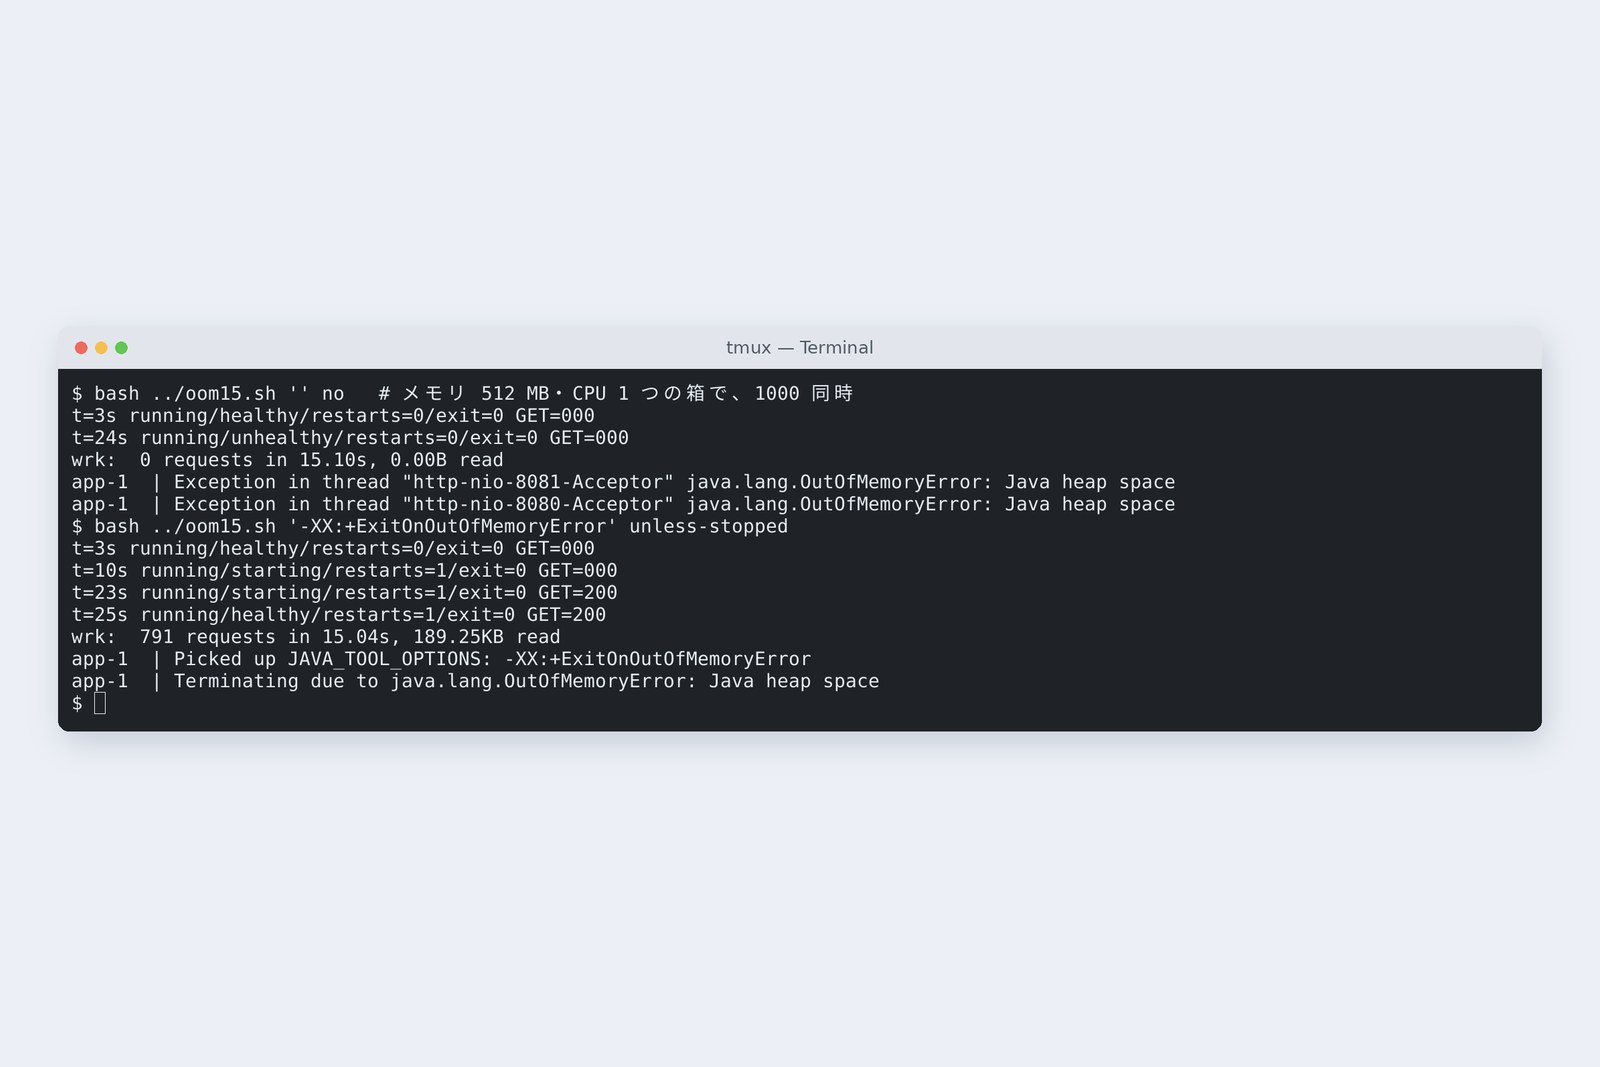
# 512 MB・CPU 1 つの箱で、仮想スレッド、200 ms 待つ窓口に同時 1000(15 秒)
  ヒープ 25%(既定)ヒープを使い切る。受付のスレッド(Acceptor)が止まり、何も受け付けない
                                    さばけたのは 0〜247 件(4回)。プロセスは生きたまま
                                    約 25 秒後に unhealthy。それでも running のまま
  ヒープ 75%ヒープ+そのほかが 512 MB を超え、カーネルが止めた(OOMKilled)
  25% + ExitOnOutOfMemoryErrorすぐ終了 → restart で起こしなおし、20 秒あまりで 200
  ヒープ 60%15 秒で 7121 件。使ったメモリ 466 MiB / 512 MiB
512 MB の箱で、ヒープの割合を変えた(実測)
既定の 25% では、ヒープを使い切り、受付のスレッドまで止まりました。プロセスは生きているので、Docker から見ると running のまま。健康診断で unhealthy にはなりますが、restart の仕組みはプロセスが終わったときに働くので、この状態からは戻りません。-XX:+ExitOnOutOfMemoryError で JVM を終わらせると、restart で起こしなおされ、20 秒あまりで 200 が返りました。
ヒープを 75% にすると、こんどはヒープの外の分(スレッドのスタック、JIT、ライブラリ)と合わせて 512 MB を超え、カーネルに止められました。60% では 15 秒で 7,121 件をさばき、466 MiB を使いました。ヒープは箱から決まり、少なすぎても多すぎても止まる。負荷をかけて、使った量を見てから決めます。
全15回をふりかえる
経費精算の申請を1件受けるだけのアプリに、15 回かけて、たくさんの「当たり前」を足してきました。
| 回 | テーマ | 覚えておきたい1行 |
|---|---|---|
| 1 | 全体図 | 申請1件は、Tomcat→窓口→担当者→倉庫番→DB と旅をする |
| 2 | Java の準備 | お金は BigDecimal、瞬間は Instant、日付は時差に注意 |
| 3 | 素手で HTTP | 長さはバイト、1人ずつだと黙る客で止まる |
| 4 | 素手で DB | 文字をつなげて SQL を作らない |
| 5 | Spring Boot | Bean は1つ。フィールドに頼みごとの値を置かない |
| 6 | 入力チェック | 印は窓口で、最後の守りは DB の CHECK |
| 7 | 例外と返事 | 返事は ProblemDetail、500 には問い合わせ番号 |
| 8 | DB アクセス | 同じ答えでも SQL の本数を見る(N+1) |
| 9 | 同時更新 | 読んで引いて書かない。SQL の中で引くか、版番号 |
| 10 | 状態遷移 | 遷移は表で決め、where で守る |
| 11 | 認証と認可 | 名乗りを信じない。他人の申請は 404 |
| 12 | ファイル | 名前も中身の申告も信じない。置く名前は自分で付ける |
| 13 | ログと監視 | 1件に1行と番号、全体は数、生きているかは health |
| 14 | テスト | 直したら、壊して落ちるのを見る |
| 15 | 動かす | 形はソースに、秘密は外に、待つ時間と箱の大きさは自分で決める |
どの回も、まず素朴に書いて、測って、困ったところを直しました。直したことは第14回のテストが覚え、この回で、別の場所でも同じ形で動くようになりました。新しい道具はこれからも出てきますが、書いて、測って、壊して確かめるやり方は、いにしえから変わりません。
結 — 一枚まとめと、おわりに
- 練習の部屋の外では、表が1つしかできず、500 と 401。DB の形は Flyway でソースに。当てたファイルは直さない。
- 像は層に分けて(変わるのは 451 kB)、root でなく、秘密は環境変数で。
- compose は健康診断を待って順に起動。11 秒で3つがそろう。
- nginx は上限・転送のヘッダー・接続の使い回しまで。素直なままでは 413 の HTML、Secure なし、502。
- 仮想スレッドは待つ仕事で 1 秒 960 → 2,560 件。トランザクションの中で待つなら 49 件のまま。
- 止める猶予は Spring より長く。ヒープは箱から決め、止まったまま生きている状態を作らない。
新井いにしえのやり方って、結局ぜんぶ、今も使うことばかりでしたね。
古井道具の名前は変わっても、頼みごとが届いて、だれかが確かめて、どこかに書いて、返事をする。その流れは同じだからね。15 回、おつかれさま。
参考
- Flyway — Versioned migrations
- Flyway — Validate(checksum)
- Spring Boot — Dockerfiles(jarmode tools、layers)
- Spring Boot — Graceful Shutdown
- Docker — Control startup and shutdown order in Compose
- nginx — ngx_http_upstream_module(keepalive)
- NGINX Blog — Keep-alive to upstreams is now default in NGINX 1.29.7
- JEP 444: Virtual Threads
- JEP 491: Synchronize Virtual Threads without Pinning
記録は、筆者がクラウド上の Linux(Ubuntu 24.04、カーネル 6.18、CPU 2 つ、メモリ 8 GB)で、Docker 29.9.2・Docker Compose 5.6.1 を使い、Spring Boot 4.1.2(Flyway 12.4.0、Tomcat 11.0.27、HikariCP 7.0.2、MyBatis 3.5.19)を eclipse-temurin:25-jre(Temurin 25.0.5、Ubuntu 26.04)の像で、PostgreSQL 16.15(postgres:16)と nginx 1.30.6(nginx:1.30-alpine)とともに動かして、2026年10月31日に取ったものです。負荷は wrk 4.1.0 で、同じ PC から送りました(CPU を取り合うので、数字は比べるためのものです)。表の範囲は3回の実測の最小と最大、図の棒は中央値です。証明書とパスワードは練習用です。表の数字や出力はすべて、そのときのコマンドの出力から読んだ実際の値です。登場人物は架空の人物です。
いにしえのバックエンド入門 第15回(最終回) — 動かす / 2026.10