Old-School Networking / 2026 ・ No.10
古法网络入门
第10讲 HTTP ── 把申请按钮的内容一行一行地读
发布
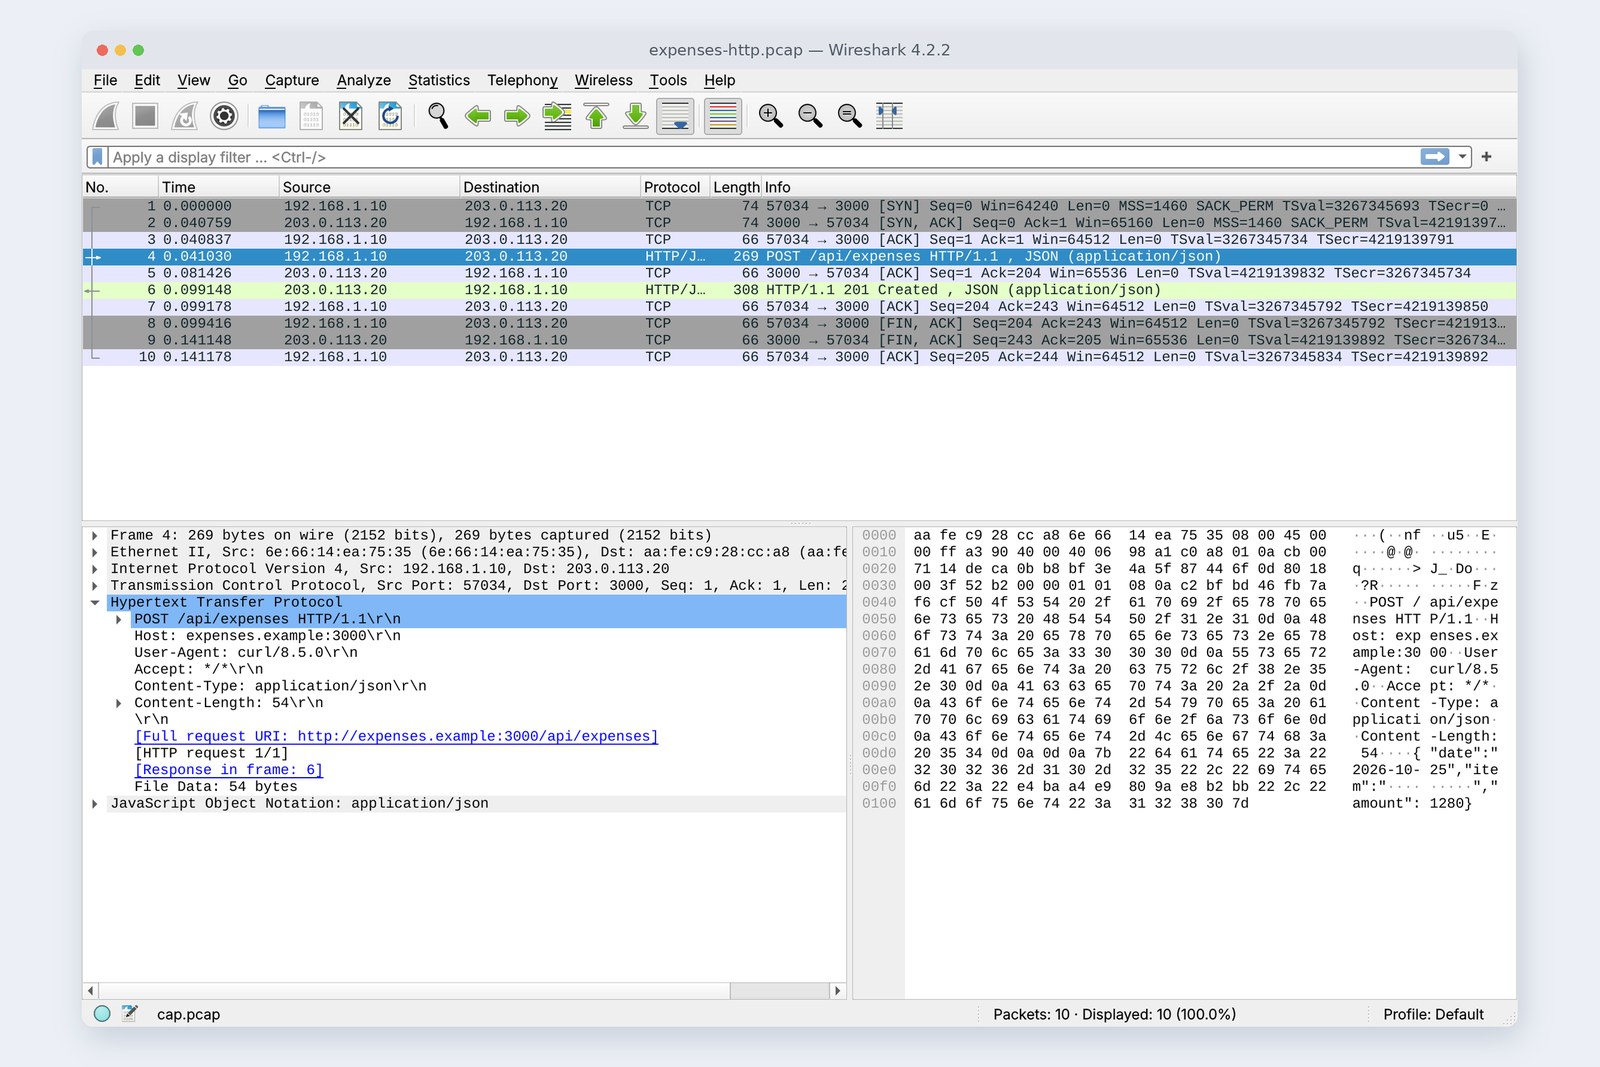
从第 1 讲一直发送的 POST /api/expenses。查了名字(第 9 讲),连上了(第 6 讲),上了锁(第 8 讲),终于要读它的内容了。
HTTP 是由一行行文字组成的“请求”和“回复”。结构、方法、状态码、缓存(ETag 与 304)、Cookie、CORS、压缩,以及 HTTP/1.1、2、3 的区别,都在练习用的服务器上实测确认。
读申请的那一层
新井从第 1 讲花了 9 讲,终于轮到申请的内容了。好漫长的旅程。
古井信封上的地址、邮路、挂号的锁,这些是下面的层。今天拆开信纸。
新井信纸上写的是什么?
古井普通得让人泄气的文字。“POST /api/expenses,内容是 JSON,54 字节”。人能读懂。
全 12 讲路线图(当前位置:第 10 讲)
- 结构 ── 第 1 行、头部、空行、正文。申请是头部 149 字节+正文 54 字节(实测)
- 方法与状态 ── 要做什么,以及结果如何。本讲让服务器返回了 10 种状态码(实测)
- 加速的办法 ── 304 让正文 0 字节,gzip 把 2 MB 变成 6 KB,HTTP/2 在一条连接上同时进行(实测)
- 开发者的陷阱 ── Cookie 的三个标记,CORS 错误该由谁来修
按 TCP/IP 的分层,HTTP 属于第 7 层,是应用层最上面的约定。练习网络和第 9 讲相同:电脑,以及单程 20 毫秒的捣乱线对面的申请服务器(Node.js)。服务器在 HTTP(3000 号)、HTTPS(3443 号,同时支持 HTTP/1.1 和 HTTP/2)、不加密的 HTTP/2(3080 号,观察用)上等待。
请求和响应的结构
为了看内容,先用不上锁的 HTTP 发送申请,用 curl -v 和 Wireshark 记录下来(Wireshark 的界面见封面照片)。
# 请求:第 1 行(方法、路径、版本)、头部、空行、正文
    POST /api/expenses HTTP/1.1
    Host: expenses.example:3000
    User-Agent: curl/8.5.0
    Accept: */*
    Content-Type: application/json
    Content-Length: 54

    {"date":"2026-10-25","item":"交通費","amount":1280}
# 响应:第 1 行(版本、状态码)、头部、空行、正文
    HTTP/1.1 201 Created
    Location: /api/expenses/EXP-2026-0012
    Content-Type: application/json
    Content-Length: 43
    Date: Sun, 25 Oct 2026 00:28:31 GMT
    Connection: keep-alive
    Keep-Alive: timeout=5

    {"id":"EXP-2026-0012","status":"submitted"}
请求和响应都由第 1 行、头部、空行、正文四部分组成
请求的第 1 行是“做什么(POST)、对哪里(/api/expenses)、用哪个版本(HTTP/1.1)”。接下来的头部是“名字: 值”的行,Host 是目标的名字(一台服务器要负责好几个名字,所以必须写),Content-Type 是正文的种类,Content-Length 是正文的长度。空行表示头部结束,后面是 54 字节的 JSON。
第 6 讲说过,TCP 是没有分界的“流”。到哪里为止算一个申请,只能由上层决定。答案就在这里:到空行为止是头部,从那里起 Content-Length 字节是正文。服务器按这个规则切分数据流。
响应的第 1 行是“版本、状态码、说明”。201 Created 表示“已创建”,Location 里写着新申请的位置。最后的 Connection: keep-alive 和 Keep-Alive: timeout=5 的意思是“这条连接会保持 5 秒,下一个请求也可以用”。第 6 讲和第 8 讲看到的、省掉 TCP 和 TLS 寒暄的“连接复用”,就是在这里约定的。
Wireshark 的第 4 个数据包是 269 字节。以太网 14、IP 20、TCP 32(带时间戳)、HTTP 头部 149、正文 54,加起来正好 269。从第 2 讲开始的各层,全都装在一个数据包里。
方法:要做什么
第 1 行的第一个词是方法。同样是 /api/expenses,GET 是“给我看列表”,POST 是“新提交一个申请”。
| 方法 | 含义 | 只读(安全) | 做几次都一样(幂等) | 在报销应用里 |
|---|---|---|---|---|
| GET | 获取 | ○ | ○ | 看列表 |
| POST | 发送并请对方处理 | × | × | 提交申请 |
| PUT | 整个替换 | × | ○ | (这台练习服务器返回 405) |
| PATCH | 改写一部分 | × | × | 只改金额 |
| DELETE | 删除 | × | ○ | 撤回申请 |
重要的是右数第 2 列,幂等。意思是“同一个请求发多少次,结果都和发一次一样”。HTTP 规范(RFC 9110)把 GET、HEAD、OPTIONS 等安全方法以及 PUT、DELETE 定为幂等。幂等的话,即使没等到回复就超时了,也可以放心重发。
新井POST 不是幂等的……那回复太慢,我把申请按钮按了两次呢?
古井交通费 1,280 日元变成两条。你得向财务道歉两次。所以按钮按下后要变灰,服务器也要能认出重复的申请。两样都要。
状态码:结果如何
故意用各种方式向练习服务器发请求,把回复的第 1 行排在一起。
# 向同一个 API 发送各种请求时的回复(第 1 行和相关头部)
    GET /api/expenses                  → 200 OK
    POST /api/expenses(JSON)         → 201 Created Location: /api/expenses/EXP-2026-0013
    POST(JSON 损坏)                  → 400 Bad Request
    POST(Content-Type: text/plain)   → 415 Unsupported Media Type
    POST(amount 是字符串)            → 422 Unprocessable Entity
    PUT /api/expenses                  → 405 Method Not Allowed Allow: GET, POST
    GET /expenses(旧 URL)            → 301 Moved Permanently Location: /api/expenses
    GET /api/expenses/EXP-2026-9999    → 404 Not Found
    DELETE(没有钥匙)                 → 401 Unauthorized WWW-Authenticate: Bearer
    DELETE(带钥匙)                   → 204 No Content
按第一个数字分成 5 组(方块是本讲实测返回的状态码)
三位数的第一个数字表示类别。2xx 是成功,3xx 是“去别处”,4xx 是“请求方的问题”,5xx 是“服务器的问题”。4xx 由发送方(前端)来改,5xx 由服务器一侧来改。出故障时首先看的,就是这一位数。
4xx 里也有区分。400 是 JSON 坏了读不了,415 是“只收 JSON,却来了 text/plain”,422 是“读得懂,但金额是字符串,内容不对”。401 是“不知道你是谁(请出示钥匙)”,用 WWW-Authenticate 附上钥匙的种类。知道是谁、但“不允许你”的是 403。
该看的是数字,不是后面的说明文字。规范 RFC 9110 把 422 的名字改成了“Unprocessable Content”,而本讲的 Node.js 返回的还是旧的“Unprocessable Entity”。这完全没有影响。HTTP/2 甚至连说明文字都没有,第六章的记录里也只有 HTTP/2 200 这个数字。
缓存:ETag 与 304
报销列表每次打开,返回的内容几乎都一样。每次都全部运送很浪费。于是服务器在返回列表的同时,附上内容的标记 ETag。
# 第 1 次:列表和内容的标记(ETag)一起返回
pc$ curl -D - http://expenses.example:3000/api/expenses
    HTTP/1.1 200 OK
    ETag: "41dc1e7dc5a9"
    Cache-Control: no-cache
    (正文 153 bytes)
# 第 2 次:附上“这个标记的我已经有了”再问
pc$ curl -D - -H 'If-None-Match: "41dc1e7dc5a9"' http://expenses.example:3000/api/expenses
    HTTP/1.1 304 Not Modified
    ETag: "41dc1e7dc5a9"
    (正文 0 bytes)
没变的话只回答“304,沿用之前的就行”
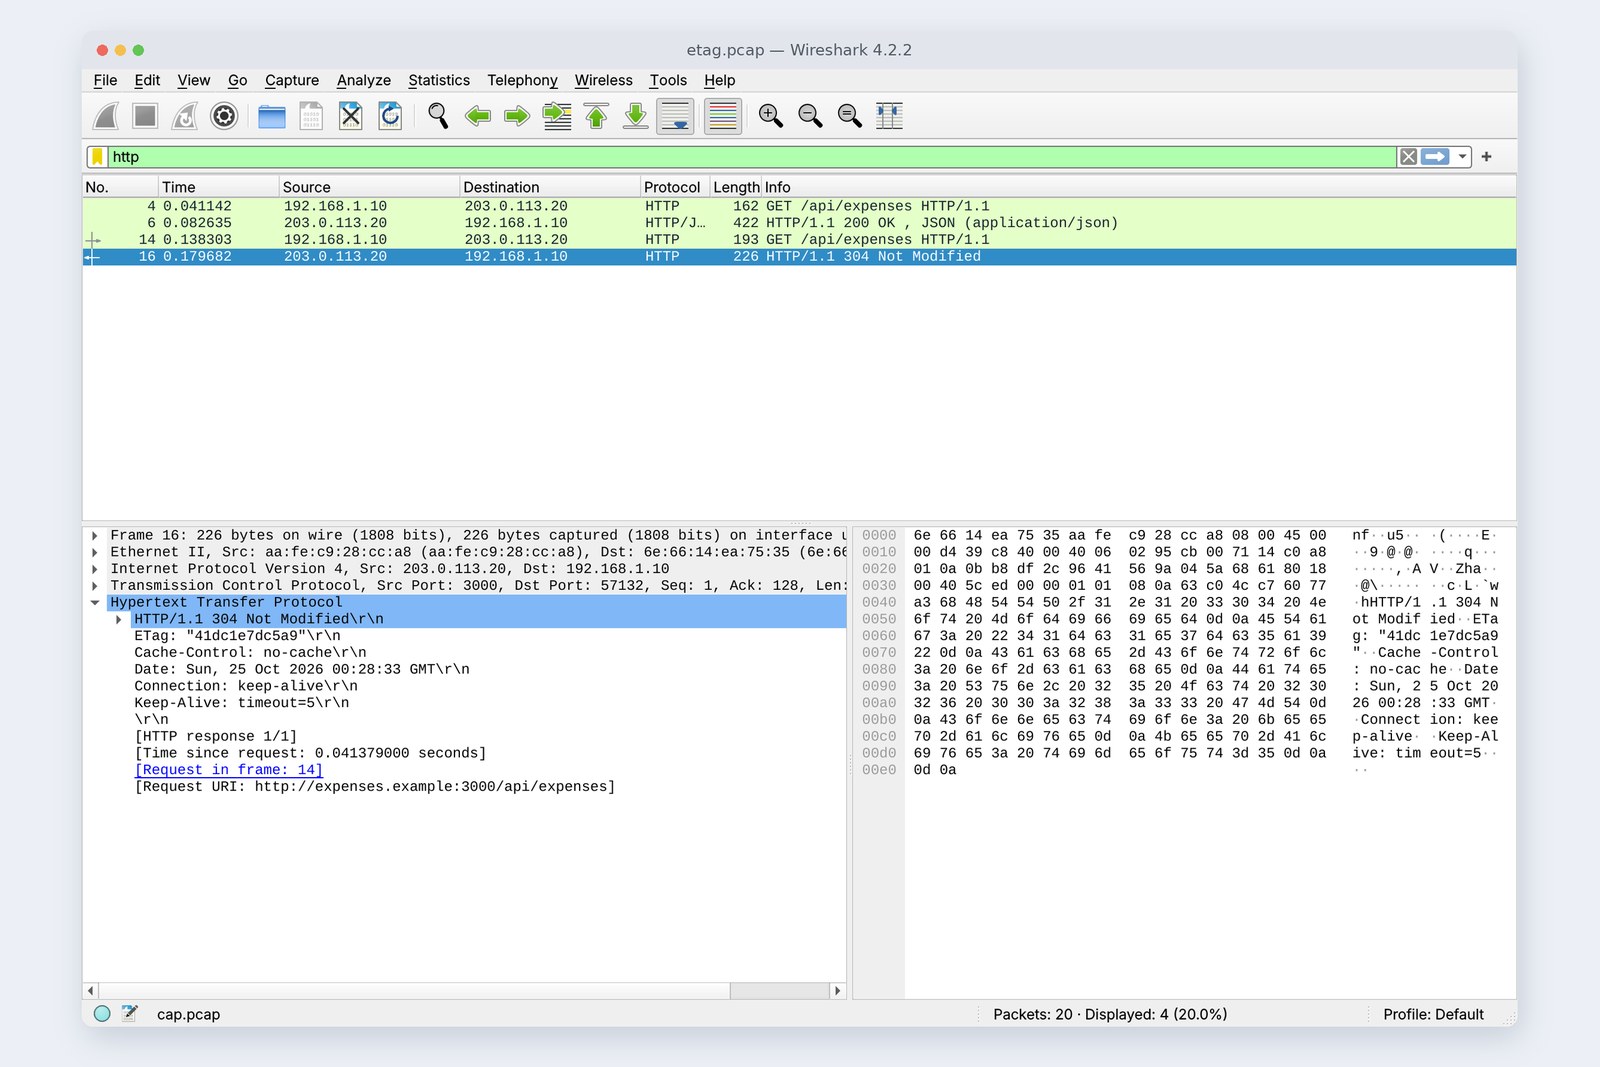
第 2 次用 If-None-Match 附上“这个标记的我已经有了”再问,服务器因为内容没变,用 304 Not Modified、正文 0 字节来回答。往返次数一样,但列表越大越有效。浏览器不用吩咐,就会自动这样做。
Cache-Control: no-cache 和名字相反,不是“别存”,而是“可以存,但每次使用前都要向服务器确认”(RFC 9111)。真的不想被存时用 no-store。max-age=600 是“10 分钟内不用问就可以用”,这期间连往返都没有了。
“改好了画面却不变”,多半是缓存。开发时在浏览器开发者工具 Network 标签里勾上“Disable cache”,可以少很多烦恼。
健忘的 HTTP 与 Cookie
HTTP 在一个请求结束后就把一切忘掉(无状态)。那“已登录”是怎么记住的呢?从这里开始用 HTTPS(3443 号)来试。
# 登录前问“我是谁?”
pc$ curl https://expenses.example:3443/api/me
    {"error":"login required"}
# 登录后,服务器发给 Cookie
pc$ curl -c jar.txt -X POST … https://expenses.example:3443/login
    HTTP/2 200
    set-cookie: sid=480df7…; Path=/; HttpOnly; Secure; SameSite=Lax
# 下一个请求带上 Cookie 再问
pc$ curl -b jar.txt https://expenses.example:3443/api/me
    {"user":"arai"}
发一张号码牌,之后每次都请对方出示
登录后,服务器用 Set-Cookie 发一张号码牌(sid)。电脑把它收好,之后每次向同一台服务器发请求时都作为 Cookie 带上。服务器根据号码查出“是新井”。HTTP 本身依旧健忘,让它“假装”记得的就是 Cookie。第 8 讲看到的 OSI 第 5 层“会话管理”的职责,实际上就是在这里完成的。
号码牌后面的三个标记,是开发者最在意的地方。HttpOnly 让 JavaScript 读不到,Secure 只在 HTTPS 时发送,SameSite=Lax 在从别的网站跳过来时,大多数请求都不带上。号码牌就是钥匙本身,所以要让它不容易被偷、不容易被冒用。
带 Secure 的 Cookie 不会发给 http:// 的页面。开发中遇到“登录了却马上变回未登录”,首先怀疑这一点。另外,浏览器常常对 localhost 特殊对待,这个留到第 11 讲。
CORS:浏览器的守门人
假设页面放在 https://app.expenses.example,API 放在 https://expenses.example:3443。名字不同,所以两者是不同的 Origin(http/https、名字、端口的组合)。浏览器通常不允许某个页面的 JavaScript 读取另一个 Origin 的回复。由 API 一方回答允许与否的约定,就是 CORS。
POST JSON 时,浏览器会在正式请求之前先用 OPTIONS 做一次“预检”(preflight)。下面用 curl 重现了这个预检。
# 预检(preflight):能否从 https://app.expenses.example 的页面发 POST
    OPTIONS /api/expenses
    Origin: https://app.expenses.example
    Access-Control-Request-Method: POST
    Access-Control-Request-Headers: content-type
  →
    HTTP/2 204
    access-control-allow-origin: https://app.expenses.example
    access-control-allow-methods: GET, POST, DELETE
    access-control-allow-headers: Content-Type, Authorization
    access-control-max-age: 600
# 来自陌生 Origin(https://other.example)时,不附带许可的头部
  →
    HTTP/2 204
浏览器先预检,被许可才发送正式请求
对许可的 Origin 会带上 Access-Control-Allow-Origin 等头部,对不认识的 Origin 什么都不带。两者都是 204,请注意服务器并没有说“拒绝”。拦下来的是浏览器。没有许可的头部,浏览器就不发送正式请求,并在开发者工具的 Console 里显示 CORS 错误。
新井那个 CORS 错误,我怎么改前端代码都消不掉。
古井当然。该改的是服务器的回复。curl 不报这个错也是同样的道理,curl 没有守门人。
压缩
在限速到 10 Mbit/s 的线上,导出报销 CSV(2 MB)。
# 2 MB 的 CSV,原样/用 gzip(10 Mbit/s、单程 20 ms 的线)
pc$ curl https://expenses.example:3443/api/export.csv
    2,097,152 bytes   1.934 s
pc$ curl --compressed …   (Accept-Encoding: deflate, gzip, br, zstd → Content-Encoding: gzip)
        6,179 bytes   0.142 s
电脑用 Accept-Encoding 告诉对方“这些压缩方式我能读”,服务器用 Content-Encoding: gzip 压缩后返回。2,097,152 字节变成 6,179 字节,1.934 秒变成 0.142 秒。浏览器也会自动这样做。
不过这个 CSV 是同一行的重复,所以压得极小。另做一个编号、日期、金额各不相同的 2 MB CSV,同样用 gzip 压缩,是 428,597 字节,约五分之一。文字数据(HTML、JSON、CSV)压缩效果好,本来就压缩过的 JPEG 和视频几乎压不动。
压缩过的回复要带上 Vary: Accept-Encoding。意思是“这个回复随 Accept-Encoding 而变”,防止途中的缓存把压缩过的回复交给读不了 gzip 的一方。
HTTP/1.1、2、3
一个页面通常由几十个请求组成。用 HTTPS 获取 6 个各需 100 毫秒的报告,做了比较。
# 6 个各需 100 ms 的报告(HTTPS、单程 20 ms)
    HTTP/1.1 依次          0.953 s   1条连接
    HTTP/1.1 同时          0.246 s   6条连接
    HTTP/2 同时            0.245 s   1条连接
获取 6 个报告所用的时间(实测)
HTTP/1.1 一条连接一次只能处理一个请求。依次进行的话,即使复用连接也要 0.953 秒。要加快只能多建几条连接,6 条是 0.246 秒。浏览器出于同样的原因,对同一个对象会建 6 条左右的连接。相应地,TCP 和 TLS 的寒暄也要 6 次。
HTTP/2 在一条连接上给请求编号(流),同时推进(多路复用)。仍是一条连接,0.245 秒。内容从文字行变成了二进制的帧,但方法、状态码、头部的含义都一样。
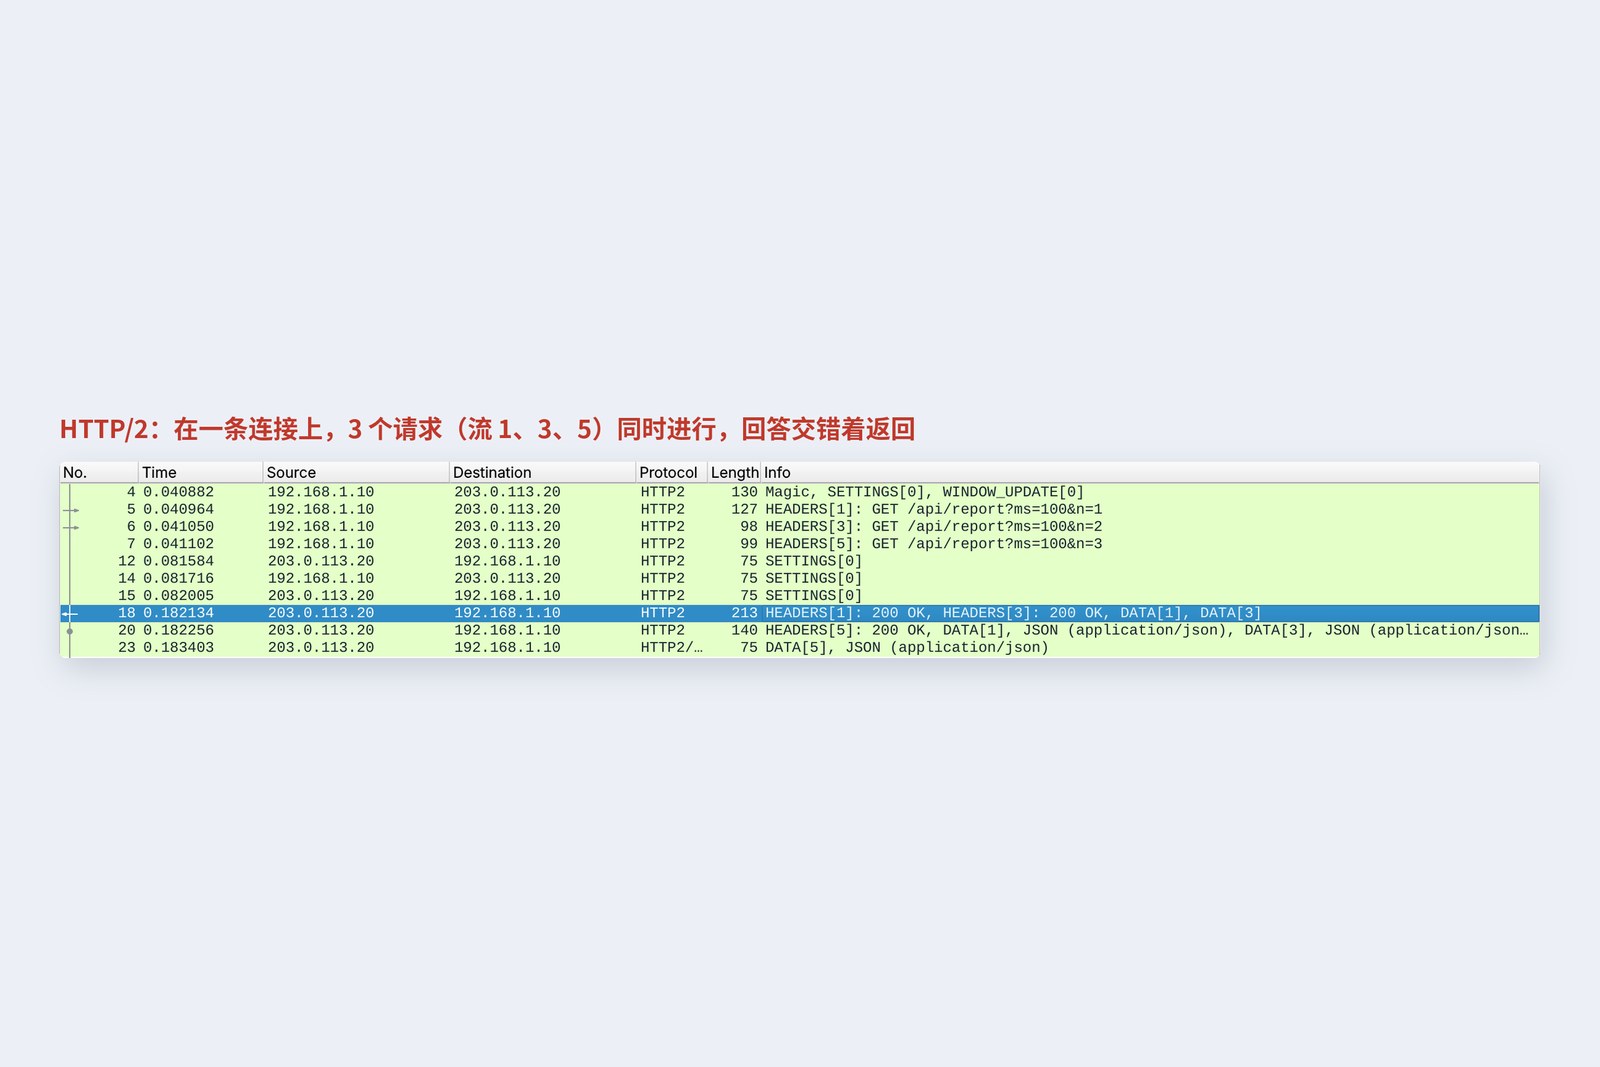
在 HTTPS 上,用哪个版本说话是在 TLS 握手时顺便决定的(ALPN。在第 8 讲看到的 Client Hello 里写上“我也会说 h2”发过去)。浏览器只在 HTTPS 时使用 HTTP/2,照片里不加密的 HTTP/2 是为了观察而做的特殊设置。
HTTP 的版本及其下层
HTTP/2 仍留有弱点。下面的 TCP 是一条流,丢一个数据包,无关的流也要等重发(第 7 讲的“队头阻塞”)。于是 HTTP/3 搬到了 UDP 之上的 QUIC。QUIC 按每条流保证顺序,也内置了 TLS 1.3。浏览器通过回复里的 Alt-Svc 头部或 DNS 的 HTTPS 记录(第 9 讲)得知“这个对象也会说 HTTP/3”,之后就切换过去。
在自己的电脑上确认
| 想查的事 | 浏览器(开发者工具) | curl |
|---|---|---|
| 一行行看请求和回复 | 在 Network 标签选中一行,看 Headers | curl -v https://example.com/ |
| 只看状态码 | Network 标签的 Status 列 | curl -s -o /dev/null -w '%{http_code}\n' URL |
| 使用的版本 | 右键列标题,显示 Protocol(h2、h3) | curl -sI --http2 URL |
| 缓存 | Size 列的“(disk cache)”、304 的行 | curl -D - -H 'If-None-Match: "…"' URL |
| 压缩 | Size 列(运送的量和解压后的大小) | curl --compressed -w '%{size_download}\n' URL |
| CORS 预检 | Type 为 preflight 的行、Console 的错误 | curl -X OPTIONS -H 'Origin: …' -i URL |
先打开平时常用的网站,看看 Network 标签吧。一个页面里有多少请求、用哪个版本、压缩了多少,一目了然。
结 — 一页总结与下一讲
- HTTP 是文字行。第 1 行、头部、空行、正文。正文长度看 Content-Length(TCP 数据流的切分方法)。
- 方法表示要做什么。GET、PUT、DELETE 是幂等的,可以重发。POST 要小心重复申请。
- 状态码看第一个数字。4xx 由发送方改,5xx 由服务器改。说明文字只是装饰。
- 用 ETag 与 304,没变就正文 0 字节。no-cache 是“每次都确认”。
- HTTP 很健忘。用 Cookie 的号码牌“假装”记得。HttpOnly、Secure、SameSite。
- 拦下 CORS 的是浏览器,要改的是服务器的回复。
- gzip 把 2 MB 变成 6 KB(普通 CSV 约五分之一)。HTTP/2 在一条连接上同时进行,HTTP/3 跑在 QUIC(UDP)之上。
新井这样申请按钮的旅程就全部走完了!可是,我电脑上的 localhost:3000 在这张地图的哪里呢?
古井好问题。下一讲是开发者的网络。localhost、Docker 的里和外、代理。每天都在用,却最容易迷路的地方。
参考
- RFC 9110 — HTTP Semantics
- RFC 9111 — HTTP Caching
- RFC 9112 — HTTP/1.1
- RFC 9113 — HTTP/2
- RFC 9114 — HTTP/3
- RFC 9000 — QUIC: A UDP-Based Multiplexed and Secure Transport
- RFC 2068 — Hypertext Transfer Protocol -- HTTP/1.1(1997)
- RFC 7540 — Hypertext Transfer Protocol Version 2(2015)
- RFC 6265 — HTTP State Management Mechanism(Cookie)
- RFC 7838 — HTTP Alternative Services(Alt-Svc)
- RFC 9460 — SVCB and HTTPS Resource Records
- WHATWG — Fetch Standard(CORS)
- MDN — Cross-Origin Resource Sharing (CORS)
- MDN — Connection management in HTTP/1.x
- curl — man page
- Node.js — HTTP/2
记录来自笔者在云端 Linux(Ubuntu 24.04,内核 6.18)上用网络命名空间搭建的练习网络,于 2026 年 10 月 25 日抓取。服务器是用 Node.js 22.23 的 http、http2 模块写的练习用程序,电脑一侧是 curl 8.5.0,名字和地址都是为说明而保留的或为练习而制作的。电脑和服务器之间是第 6 讲的捣乱线(单程 20 毫秒,仅压缩一章限速 10 Mbit/s)。表中的数字都是从这些记录和当时命令的输出读出的实际数值。各不相同的 CSV 的压缩,是把笔者制作的 2 MB CSV 用相同强度(6)的 gzip 压缩所得的值。登场人物均为虚构。
古法网络入门 第10讲 — HTTP / 2026.10