Old-School Backend / 2026 ・ No.08
いにしえのバックエンド入門
第8回 DB アクセス ── JdbcClient・JPA・MyBatis で同じ一覧を書いて比べる
公開
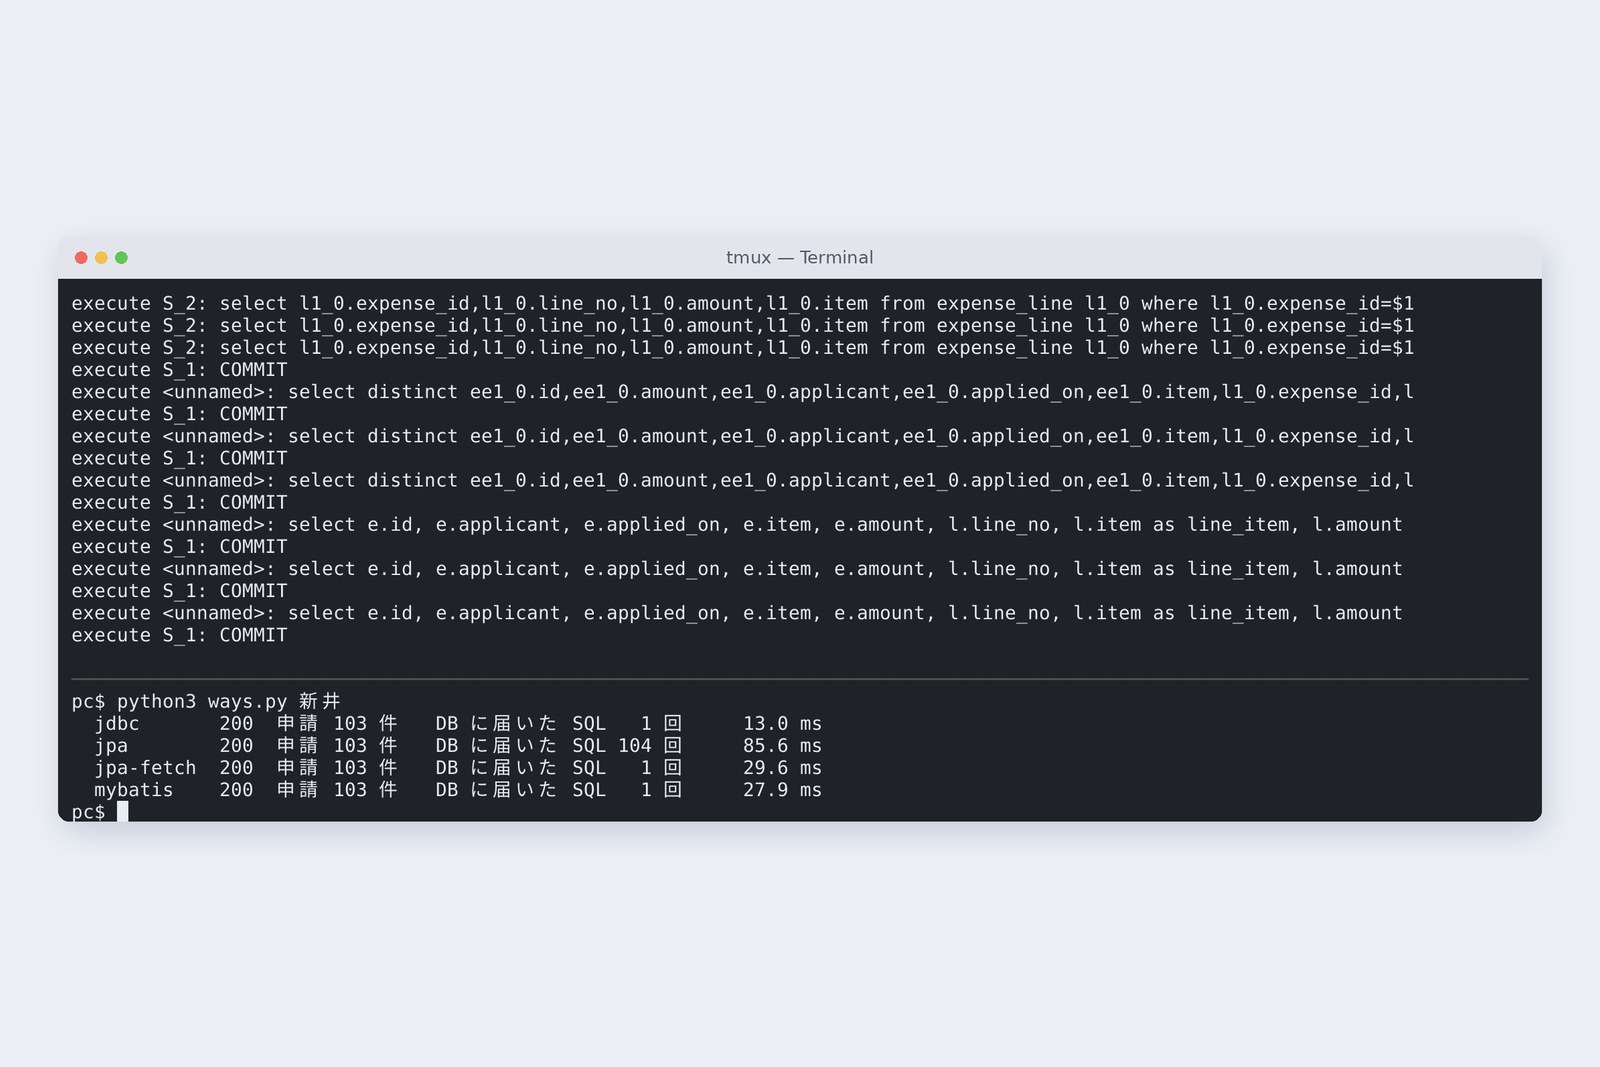
第1回から、倉庫番は SQL を手で書く JdbcClient でした。Java の現場には、ほかにも定番の倉庫番がいます。SQL を自動で作る JPA(Hibernate)と、SQL を XML に書く MyBatis です。
今回は「申請一覧と、その明細」という同じ仕事を3つの道具で書き、DB に何本の SQL が届くか、どこに落とし穴があるかを実測します。N+1、save しないのに走る update、open-in-view、MyBatis の ${} です。
倉庫番を選ぶ
新井SQL を書かなくていい JPA があるのに、なんで手で書いてたんですか。
古井書かなくていい、は「書かれていない」ではない。だれかが書いている。だれが、いつ、何本書いたか、今日は数えよう。
新井MyBatis は? 前の現場で使ってました。
古井日本の業務システムでは、いまも多い。あれにも1つ、第4回と同じ落とし穴がある。
全15回の路線図(いまここ:第8回)
- 3つの書き方 ── 同じ答え(JSON がバイトまで一致)を、35 行・62 行・56 行で
- N+1 ── JPA をそのまま使うと、1 本で済む SQL が 104 本(実測)
- 勝手な update ── save を呼ばないのに、DB が書きかわった(実測)
- open-in-view ── 既定のままだと窓口で SQL が出て、切ると 500(実測)
- ${} ── MyBatis でも、書き方1つで SQL インジェクション(実測)
アプリは前回の Spring Boot 4.1.2 に、JPA(Hibernate 7.4、Spring Data JPA 4.1)と MyBatis(3.5.19、mybatis-spring-boot 4.1.0)を足しました。DB には、新井さん 100 件・古井さん 20 件の出張の申請を入れ、それぞれに明細(新幹線、ホテル、タクシー)を3行付けました。第4回からの6件と合わせて、新井さんの申請は 103 件です。
3つの書き方
まず、手で書く JdbcClient。SQL は1本で、申請と明細をつないで(join)取り、行を Java で組み立てます。
# ① JdbcClient:SQL を手で書き、行を手で組み立てる(JdbcClaims.java の要点)
public List<ClaimView> findByApplicant(String applicant) {
    Map<String, ClaimView> byId = new LinkedHashMap<>();
    jdbc.sql("""
            select e.id, e.applicant, e.applied_on, e.item, e.amount, l.line_no, l.item as line_item, l.amount as line_amount
            from expense e left join expense_line l on l.expense_id = e.id
            where e.applicant = ? order by e.id, l.line_no""")
        .param(applicant)
        .query(rs -> {
            ClaimView c = byId.computeIfAbsent(rs.getString("id"), id -> {
                try {
                    return new ClaimView(id, rs.getString("applicant"), rs.getObject("applied_on", java.time.LocalDate.class),
                            rs.getString("item"), rs.getBigDecimal("amount"), new ArrayList<>());
                } catch (java.sql.SQLException e) { throw new RuntimeException(e); }
            });
            if (rs.getObject("line_no") != null)
                c.lines().add(new ClaimView.Line(rs.getInt("line_no"), rs.getString("line_item"), rs.getBigDecimal("line_amount")));
        });
    return new ArrayList<>(byId.values());
}
次に JPA。表の1行を Java のオブジェクト(Entity)として書き、表どうしのつながりを @OneToMany で書きます。倉庫番はインターフェースを書くだけで、メソッドの名前から Spring Data が SQL を作ります。
# ② JPA:表の1行を、Java のオブジェクトとして持つ(ExpenseEntity.java の要点)
@Entity
@Table(name = "expense")
public class ExpenseEntity {
    @Id
    private String id;
    private String applicant;
    @Column(name = "applied_on")
    private LocalDate date;
    private String item;
    private BigDecimal amount;
    private String status;

    @OneToMany(mappedBy = "expense")  // 明細は、呼ばれたときに取りに行く(LAZY)
    @OrderBy("id.lineNo")
    private List<ExpenseLineEntity> lines;
# 倉庫番はインターフェースを書くだけ(ExpenseJpaRepository.java)
public interface ExpenseJpaRepository extends JpaRepository<ExpenseEntity, String> {
    List<ExpenseEntity> findByApplicantOrderById(String applicant);  // メソッド名から SQL を作る

    @Query("select distinct e from ExpenseEntity e left join fetch e.lines where e.applicant = :applicant order by e.id")
    List<ExpenseEntity> findWithLines(String applicant);  // 明細も1回で取る
}
最後に MyBatis。SQL は XML に手で書き、結果をどう組み立てるか(resultMap)も書きます。
# ③ MyBatis:SQL と、結果の組み立て方を XML に書く(ClaimMapper.xml の要点)
<resultMap id="claim" type="example.expenses.v8.ClaimRow">
  <id property="id" column="id"/>
  <result property="applicant" column="applicant"/>
  <result property="appliedOn" column="applied_on"/>
  <result property="item" column="item"/>
  <result property="amount" column="amount"/>
  <collection property="lines" resultMap="line"/>
</resultMap>
<resultMap id="line" type="example.expenses.v8.ClaimView$Line">
  <constructor>
    <idArg column="line_no" javaType="_int"/>
    <arg column="line_item" javaType="string"/>
    <arg column="line_amount" javaType="java.math.BigDecimal"/>
  </constructor>
</resultMap>

<select id="findByApplicant" resultMap="claim">
  select e.id, e.applicant, e.applied_on, e.item, e.amount, l.line_no, l.item as line_item, l.amount as line_amount
  from expense e left join expense_line l on l.expense_id = e.id
  where e.applicant = #{applicant}
  order by e.id, l.line_no
</select>
MyBatis では1つつまずきました。明細の一覧を record のコンストラクターに渡そうとすると「argument type mismatch」で止まり、明細を後から足していける普通のクラス(ClaimRow)を入れ物にしました。道具ごとに、得意な形があります。
3つの倉庫番:だれが SQL を書き、だれが組み立てるか
同じ答え、違う SQL
4つのやり方(JPA は「そのまま」と「join fetch」の2通り)で、新井さんの申請一覧を取りました。返ってきた JSON は4つともバイトまで同じでしたが、DB に届いた SQL は違いました。
# 新井さんの申請 103 件と明細を、4つのやり方で(各5回、真ん中の値)
  JdbcClient          SQL   1 回    18.0 ms   (16.7, 17.7, 18.0, 18.0, 19.2)
  JPA(そのまま)     SQL 104 回    63.5 ms   (49.9, 62.2, 63.5, 71.2, 91.5)
  JPA(join fetch)   SQL   1 回    15.8 ms   (14.1, 14.3, 15.8, 19.6, 22.0)
  MyBatis             SQL   1 回    13.4 ms   (9.7, 12.1, 13.4, 16.6, 17.6)
# JPA(そのまま)が DB に送った SQL:最初の1本と、そのあと 103 本続いたもの
select ee1_0.id,ee1_0.amount,ee1_0.applicant,ee1_0.applied_on,ee1_0.item,ee1_0.status from expense ee1_0 where ee1_0.applicant=$1 order by ee1_0.id
select l1_0.expense_id,l1_0.line_no,l1_0.amount,l1_0.item from expense_line l1_0 where l1_0.expense_id=$1 order by l1_0.line_no   × 103
# join fetch にしたあとの1本
select distinct ee1_0.id,ee1_0.amount,ee1_0.applicant,ee1_0.applied_on,ee1_0.item,l1_0.expense_id,l1_0.line_no,l1_0.amount,l1_0.item,ee1_0.status from expense ee1_0 left join expense_line l1_0 on ee1_0.id=l1_0.expense_id where ee1_0.applicant=$1 order by ee1_0.id,l1_0.line_no
JPA をそのまま使うと、まず申請の一覧を取る SQL が1本。そのあと、明細に触るたびに「この申請の明細」を取る SQL が1本ずつ、103 本続きました。Hibernate が作った SQL は、列の名前に ee1_0 や l1_0 という別名が付いた、人が書かない形です。写真の時間は1回分で、表の時間は5回の真ん中の値なので、少し違います。
N+1:1回で済むところを 104 回
新井さんの申請 103 件と明細:DB に届いた SQL(実測)
一覧の1本(1)に、件数分(N)の SQL が足される。これが N+1 です。@OneToMany は、明細を「呼ばれたときに取りに行く」(LAZY)のが既定なので、申請を1件ずつ画面の形に詰め替えるたびに SQL が出ます。コードには SQL が1行も見えないので、レビューでは見つかりません。
直し方は、最初から明細もまとめて取ると伝えることです。この回では join fetch を書いた問い合わせ(findWithLines)で 1 本になり、15.8 ms でした。ほかに @EntityGraph や、まとめて取る件数の設定もあります。どれにしても、DB に届いた SQL を数える習慣がいちばんの薬です。
新井テストでは申請3件だったので、気づきませんでした……。
古井N+1 は、月末に経理が1年分を開いた日に目を覚ます。
save しないのに update
JPA の担当者に、「申請を読んで、表示用に品目の後ろへ『(確認済み)』と付けて返す」処理を書きました。DB に書くつもりはなく、save() も呼んでいません。
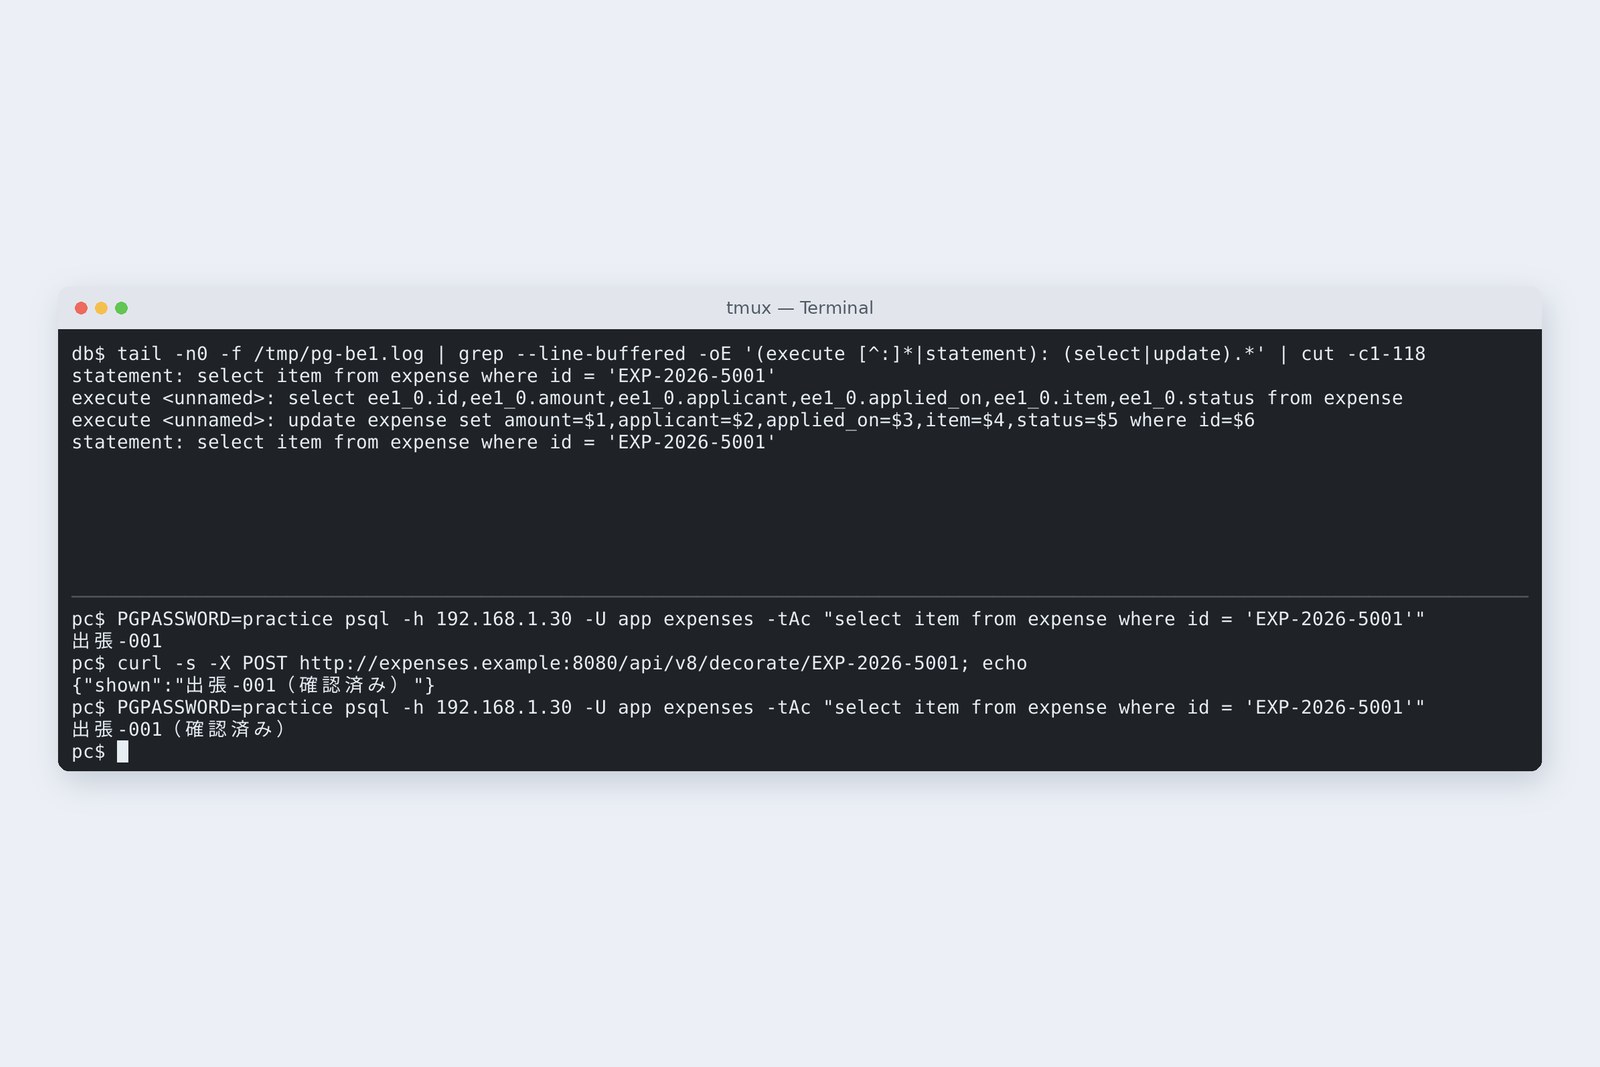
# 担当者:読んで、表示用に名前を変えただけ。save() は呼んでいない
@Transactional  // 読んで、表示用に名前を変えただけ(のつもり)
public String decorate(String id) {
    ExpenseEntity e = jpa.findById(id).orElseThrow();
    e.setItem(e.getItem() + "(確認済み)");
    return e.getItem();
}
# 前の DB/窓口を呼んだときの SQL/あとの DB
  出張-001
  select ee1_0.id,ee1_0.amount,ee1_0.applicant,ee1_0.applied_on,ee1_0.item,ee1_0.status from expense ee1_0 where ee1_0.id=$1
  update expense set amount=$1,applicant=$2,applied_on=$3,item=$4,status=$5 where id=$6
  出張-001(確認済み)
DB の品目が「出張-001(確認済み)」に書きかわりました。JPA はトランザクションの中で読んだ Entity を「持ち物」として見張っていて、コミットのときに読んだときの写しと比べ、変わっていれば update を送ります。しかも送った update は、変えた品目だけでなく全部の列を書きなおしていました。Entity は「DB の行とつながった物」で、表示のために書きかえてよい物ではありません。
JPA の「持ち物の見張り」と open-in-view
open-in-view
JPA を入れたアプリは、起動のたびに警告を出していました。
# 起動のときの警告
spring.jpa.open-in-view is enabled by default. Therefore, database queries may be performed during view rendering. Explicitly configure spring.jpa.open-in-view to disable this warning
# Entity をそのまま返す窓口(open-in-view が既定の true)
  200  rows 103  SQL 104  62.7 ms
# spring.jpa.open-in-view=false で起動すると
  500  SQL 1
  Could not write JSON: Cannot lazily initialize collection of role 'example.expenses.v8.ExpenseEntity.lines' with key 'EXP-2026-0101' (no session)
Spring Boot の既定では、見張り(open-in-view)が返事を書き終わるまで続きます。そのため、窓口が Entity をそのまま返すと、Jackson が JSON を書きながら明細に触り、窓口の段階で 104 本の SQL が出ました。spring.jpa.open-in-view=false にすると、見張りは担当者のトランザクションで終わり、窓口で明細に触った瞬間に「no session」で 500 になりました。
どちらがよいかと言えば、false にして、500 で早く気づくほうです。画面に返すものは担当者の中で別の形(この回の ClaimView)に詰め替え、必要な明細は担当者の中で取りそろえます。第5回の「窓口は HTTP の形だけ」と同じ考えです。
MyBatis の #{} と ${}
MyBatis の XML には、値の埋め方が2つあります。#{} と ${} です。
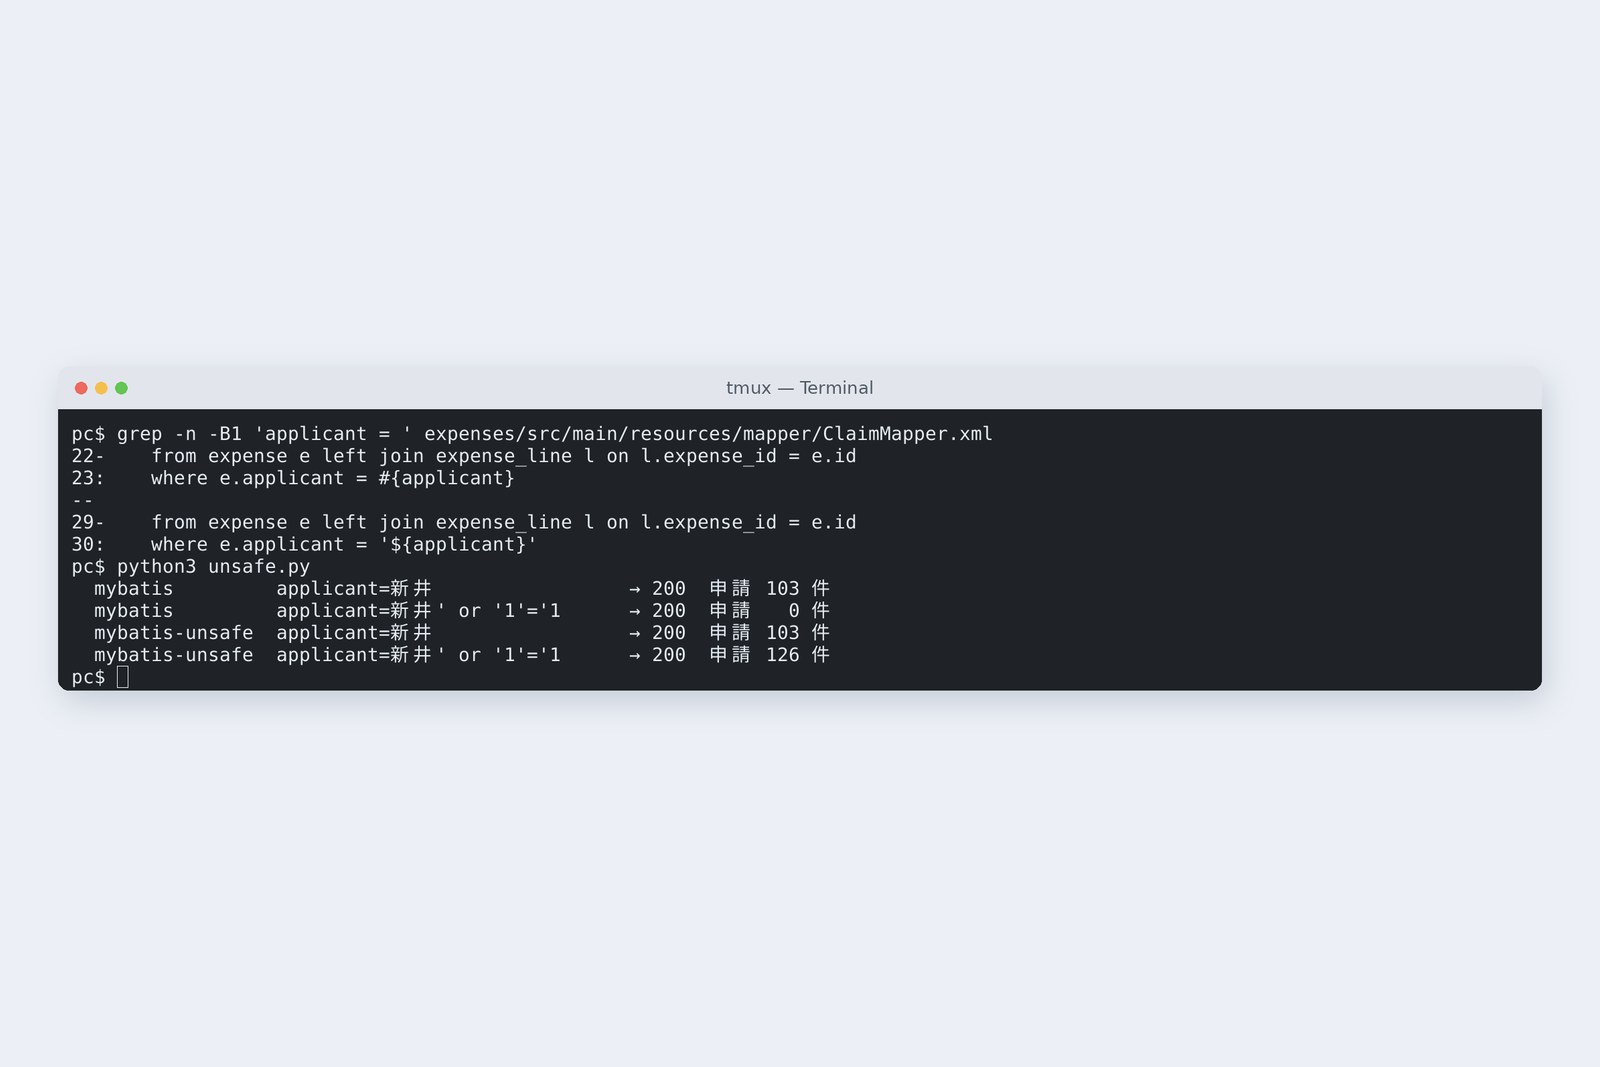
# MyBatis の2つの書き方
  #{}  where e.applicant = #{applicant}
  ${}  where e.applicant = '${applicant}'
# 同じ名前を渡す
  mybatis         新井' or '1'='1   → 200  0
  mybatis-unsafe  新井              → 200  103
  mybatis-unsafe  新井' or '1'='1   → 200  126
#{} は第4回のプレースホルダー(?)になり、引用符入りの名前は「そういう名前の人」として 0 件。${} は SQL の文字にそのまま貼りこむので、第4回と同じく全員分の 126 件が出ました。${} は並べ替えの列名のように、許可した一覧から選んだ値だけに使います(第4回の第六章)。古い MyBatis のコードを読むときは、まず ${ で検索してください。
道具の重さ
# 道具立て(第7回のアプリと比べて)
  第7回: jar 24,340,548 バイト、ライブラリ 48、起動 3.667 s / 3.558 s / 3.651 s
  第8回: jar 55,029,971 バイト、ライブラリ 75、起動 7.846 s / 8.0 s / 7.589 s
JPA と MyBatis を足すと、jar は 24 MB から 55 MB に、ライブラリは 48 個から 75 個になり、起動は 3.6 秒から 7.8 秒ほどに延びました。この回のアプリは JPA と MyBatis の両方を積んでいるので、実際にはどちらか一方ぶんです。それでも、Hibernate は起動のときに Entity を調べて準備をするぶん、立ち上がりが重くなります。
どれを選ぶか
| 道具 | 向いている場面 | 気をつけること |
|---|---|---|
| JdbcClient | 表が少ない、SQL を見ながら作りたい、性能を細かく詰めたい | 行の組み立てを自分で書く手間。SQL が Java の中に散らばる |
| JPA | 表とオブジェクトの形が近い、登録・更新・削除が中心、表が多い | N+1、持ち物の見張り(勝手な update)、open-in-view。DB に届く SQL を必ず見る |
| MyBatis | 複雑な SQL や既存の DB、SQL に強いチーム(日本の業務システムに多い) | ${}。XML と Java の2か所を行き来する |
どれを選んでも、DB に届く SQL は「だれかが書いたもの」です。SQL のログを出して数える、Entity をそのまま画面に返さない、値は必ずプレースホルダーで。この3つは道具が変わっても同じです。この連載の残りの回では、SQL がそのまま見える第1回の JdbcClient のまま進めます。同じことは JPA でも MyBatis でも書けます。
自分の PC で確かめる
| 試したいこと | 書き方 |
|---|---|
| Hibernate が作った SQL をアプリのログに出す | logging.level.org.hibernate.SQL=DEBUG |
| DB に届いた SQL を全部ログに出す(練習用 DB だけ) | alter system set log_statement = 'all'; |
| 明細もまとめて取る | select distinct e from … left join fetch e.lines … |
| 見張りを担当者の中で終える | spring.jpa.open-in-view=false |
| MyBatis の文字連結を探す | grep -rn '\${' src/main/resources |
N+1 を見つけるいちばん簡単な方法は、一覧の画面を1回開いて、DB のログの行数を数えることです。件数を 3 件から 100 件に増やして、SQL の本数も増えたら N+1 です。
結 — 一枚まとめと、次回
- JdbcClient・JPA・MyBatis は、同じ答えを返せる。違いはだれが SQL を書くか。
- JPA をそのまま使うと N+1。1 本で済む SQL が 104 本、63.5 ms。join fetch で 1 本、15.8 ms。
- JPA は読んだ Entity を見張る。save しなくても、変えれば update。Entity を表示用に書きかえない。
- open-in-view は false。画面に返す形は担当者の中で作る。
- MyBatis の ${} は文字の連結。値は #{} で。
- どの道具でも、DB に届く SQL を数える。
新井SQL のログを開くのが、ちょっと楽しくなってきました。
古井いい傾向だ。次回はトランザクションに戻る。同じ申請を、新井くんと私が同時に書きかえたらどうなるか。いにしえの「あとから保存した人が勝つ」問題だ。
参考
- Spring Framework — Using the JDBC Core Classes(JdbcClient)
- Spring Data JPA — Reference Documentation
- Hibernate ORM — Documentation
- Jakarta Persistence 3.2
- Spring Boot — SQL Databases(open-in-view)
- MyBatis 3 — Mapper XML Files(String Substitution)
- MyBatis Spring Boot Starter
記録は、筆者がクラウド上の Linux(Ubuntu 24.04、カーネル 6.18)で、Spring Boot 4.1.2(Hibernate 7.4、Spring Data JPA 4.1、MyBatis 3.5.19、mybatis-spring-boot 4.1.0)、OpenJDK 25.0.4、PostgreSQL 16.15 を使って 2026年10月31日に取ったものです。申請サーバーと DB サーバーは、1台の中に作った別々のネットワーク空間(network namespace)で、往復は 0.04 ms ほどです。時間は5回の真ん中の値(写真は1回分)で、動かすたびに変わります。行数は空行を除いた数です。表の数字や出力はすべて、そのときのコマンドの出力から読んだ実際の値です。登場人物は架空の人物です。
いにしえのバックエンド入門 第8回 — DB アクセス / 2026.10