Old-School Backend / 2026 ・ No.08
古法后端入门
第8讲 数据库访问 ── 用 JdbcClient・JPA・MyBatis 写同一个列表来比较
发布
从第 1 讲开始,仓库管理员一直是手写 SQL 的 JdbcClient。Java 的现场还有别的常用仓库管理员:自动生成 SQL 的 JPA(Hibernate),以及把 SQL 写在 XML 里的 MyBatis。
这次用三种工具写“申请列表及其明细”这同一份工作,实测有几条 SQL 送到数据库、陷阱在哪里:N+1、不调用 save 也会执行的 update、open-in-view,以及 MyBatis 的 ${}。
选择仓库管理员
新井明明有不用写 SQL 的 JPA,为什么一直手写?
古井“不用写”不等于“没人写”。总有人在写。是谁、什么时候、写了几条,今天来数一数。
新井MyBatis 呢?我在以前的现场用过。
古井在日本的业务系统里,现在也很多。它也有一个和第 4 讲一样的陷阱。
全 15 讲路线图(当前:第 8 讲)
- 三种写法 ── 同样的答案(JSON 逐字节一致),分别用 35 行、62 行、56 行
- N+1 ── 直接用 JPA,1 条就够的 SQL 变成 104 条(实测)
- 擅自 update ── 没调用 save,数据库却被改写了(实测)
- open-in-view ── 保持默认,窗口里会发 SQL;关掉则 500(实测)
- ${} ── MyBatis 也会因一种写法造成 SQL 注入(实测)
应用是在上一讲的 Spring Boot 4.1.2 上,加了 JPA(Hibernate 7.4、Spring Data JPA 4.1)和 MyBatis(3.5.19、mybatis-spring-boot 4.1.0)。数据库里放了新井 100 件、古井 20 件的出差申请,每件带 3 行明细(新干线、酒店、出租车)。加上第 4 讲的 6 件,新井的申请共 103 件。
三种写法
先是手写的 JdbcClient。SQL 只有 1 条,把申请和明细连接(join)起来取出,在 Java 里组装行。
# ① JdbcClient:手写 SQL,手工组装行(JdbcClaims.java 的要点)
public List<ClaimView> findByApplicant(String applicant) {
    Map<String, ClaimView> byId = new LinkedHashMap<>();
    jdbc.sql("""
            select e.id, e.applicant, e.applied_on, e.item, e.amount, l.line_no, l.item as line_item, l.amount as line_amount
            from expense e left join expense_line l on l.expense_id = e.id
            where e.applicant = ? order by e.id, l.line_no""")
        .param(applicant)
        .query(rs -> {
            ClaimView c = byId.computeIfAbsent(rs.getString("id"), id -> {
                try {
                    return new ClaimView(id, rs.getString("applicant"), rs.getObject("applied_on", java.time.LocalDate.class),
                            rs.getString("item"), rs.getBigDecimal("amount"), new ArrayList<>());
                } catch (java.sql.SQLException e) { throw new RuntimeException(e); }
            });
            if (rs.getObject("line_no") != null)
                c.lines().add(new ClaimView.Line(rs.getInt("line_no"), rs.getString("line_item"), rs.getBigDecimal("line_amount")));
        });
    return new ArrayList<>(byId.values());
}
然后是 JPA。把表的一行写成 Java 对象(Entity),用 @OneToMany 写表之间的关系。仓库管理员只写接口,Spring Data 根据方法名生成 SQL。
# ② JPA:把表的一行当作 Java 对象(ExpenseEntity.java 的要点)
@Entity
@Table(name = "expense")
public class ExpenseEntity {
    @Id
    private String id;
    private String applicant;
    @Column(name = "applied_on")
    private LocalDate date;
    private String item;
    private BigDecimal amount;
    private String status;

    @OneToMany(mappedBy = "expense")  // 明细在被访问时才去取(LAZY)
    @OrderBy("id.lineNo")
    private List<ExpenseLineEntity> lines;
# 仓库管理员只写接口(ExpenseJpaRepository.java)
public interface ExpenseJpaRepository extends JpaRepository<ExpenseEntity, String> {
    List<ExpenseEntity> findByApplicantOrderById(String applicant);  // 根据方法名生成 SQL

    @Query("select distinct e from ExpenseEntity e left join fetch e.lines where e.applicant = :applicant order by e.id")
    List<ExpenseEntity> findWithLines(String applicant);  // 明细也一次取回
}
最后是 MyBatis。SQL 手写在 XML 里,结果怎么组装(resultMap)也要写。
# ③ MyBatis:在 XML 里写 SQL 和结果的组装方式(ClaimMapper.xml 的要点)
<resultMap id="claim" type="example.expenses.v8.ClaimRow">
  <id property="id" column="id"/>
  <result property="applicant" column="applicant"/>
  <result property="appliedOn" column="applied_on"/>
  <result property="item" column="item"/>
  <result property="amount" column="amount"/>
  <collection property="lines" resultMap="line"/>
</resultMap>
<resultMap id="line" type="example.expenses.v8.ClaimView$Line">
  <constructor>
    <idArg column="line_no" javaType="_int"/>
    <arg column="line_item" javaType="string"/>
    <arg column="line_amount" javaType="java.math.BigDecimal"/>
  </constructor>
</resultMap>

<select id="findByApplicant" resultMap="claim">
  select e.id, e.applicant, e.applied_on, e.item, e.amount, l.line_no, l.item as line_item, l.amount as line_amount
  from expense e left join expense_line l on l.expense_id = e.id
  where e.applicant = #{applicant}
  order by e.id, l.line_no
</select>
MyBatis 这里绊了一下。想把明细列表传给 record 的构造函数时,报“argument type mismatch”停住了,于是改用可以后来追加明细的普通类(ClaimRow)当容器。每种工具都有自己擅长的形式。
三种仓库管理员:谁写 SQL,谁来组装
同样的答案,不同的 SQL
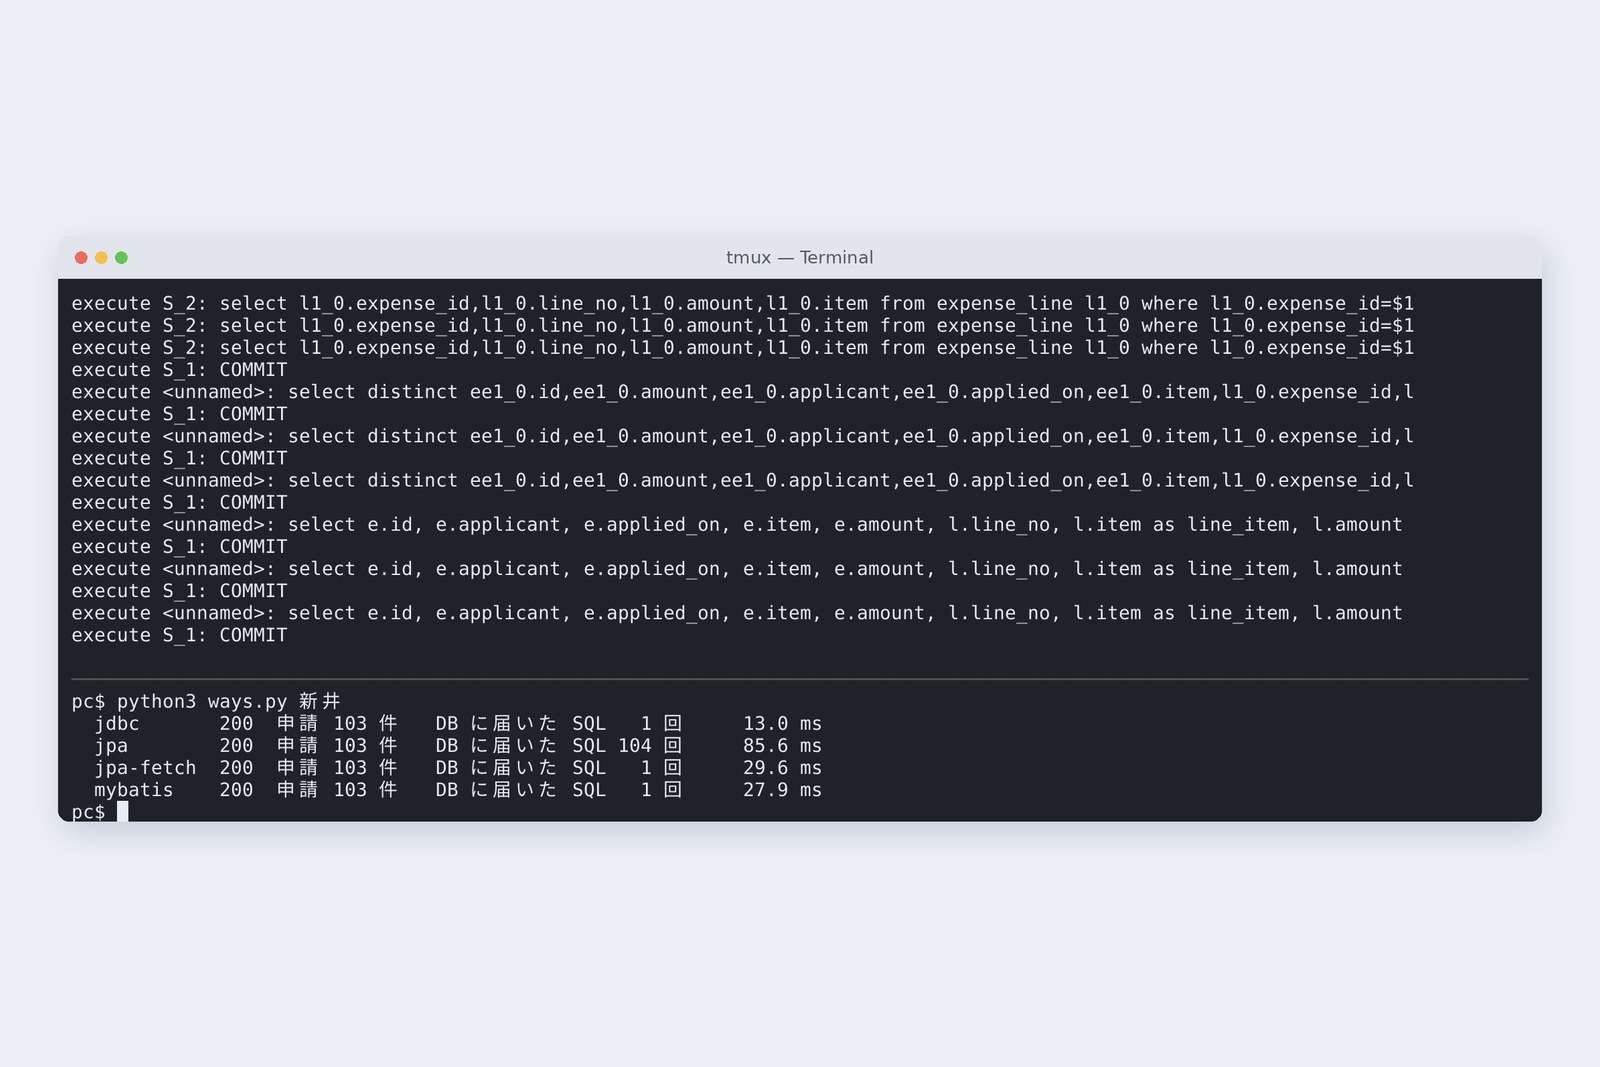
用 4 种方式(JPA 分“原样”和“join fetch”两种)取新井的申请列表。返回的 JSON 4 种逐字节相同,但送到数据库的 SQL 不同。
# 用 4 种方式取新井的 103 件申请和明细(各 5 次,取中间值)
  JdbcClient          SQL   1 次    18.0 ms   (16.7, 17.7, 18.0, 18.0, 19.2)
  JPA(原样)         SQL 104 次    63.5 ms   (49.9, 62.2, 63.5, 71.2, 91.5)
  JPA(join fetch)   SQL   1 次    15.8 ms   (14.1, 14.3, 15.8, 19.6, 22.0)
  MyBatis             SQL   1 次    13.4 ms   (9.7, 12.1, 13.4, 16.6, 17.6)
# JPA(原样)发给数据库的 SQL:第 1 条,以及后面接着的 103 条
select ee1_0.id,ee1_0.amount,ee1_0.applicant,ee1_0.applied_on,ee1_0.item,ee1_0.status from expense ee1_0 where ee1_0.applicant=$1 order by ee1_0.id
select l1_0.expense_id,l1_0.line_no,l1_0.amount,l1_0.item from expense_line l1_0 where l1_0.expense_id=$1 order by l1_0.line_no   × 103
# 改成 join fetch 之后的 1 条
select distinct ee1_0.id,ee1_0.amount,ee1_0.applicant,ee1_0.applied_on,ee1_0.item,l1_0.expense_id,l1_0.line_no,l1_0.amount,l1_0.item,ee1_0.status from expense ee1_0 left join expense_line l1_0 on ee1_0.id=l1_0.expense_id where ee1_0.applicant=$1 order by ee1_0.id,l1_0.line_no
直接用 JPA,先是取申请列表的 SQL 1 条。之后每碰一次明细,就有 1 条取“这件申请的明细”的 SQL,接连 103 条。Hibernate 生成的 SQL,列名带着 ee1_0、l1_0 这样的别名,是人不会写的样子。照片里的时间是 1 次的值,表里的时间是 5 次的中间值,所以略有不同。
N+1:1 次就够的事做了 104 次
新井的 103 件申请和明细:送达数据库的 SQL(实测)
列表的 1 条(1),再加上件数(N)那么多条 SQL。这就是 N+1。@OneToMany 默认“被访问时才去取”(LAZY),所以每把一件申请转换成画面的形式,就发出一条 SQL。代码里一行 SQL 都看不到,评审时发现不了。
改法是一开始就告诉它把明细一起取回。这一讲用写了 join fetch 的查询(findWithLines)变成 1 条,15.8 ms。另外还有 @EntityGraph、批量获取件数的设置等。无论用哪种,数一数送到数据库的 SQL 的习惯才是最好的药。
新井测试时只有 3 件申请,所以没发现……
古井N+1 会在月底财务打开一整年数据的那天醒来。
没有 save 却 update
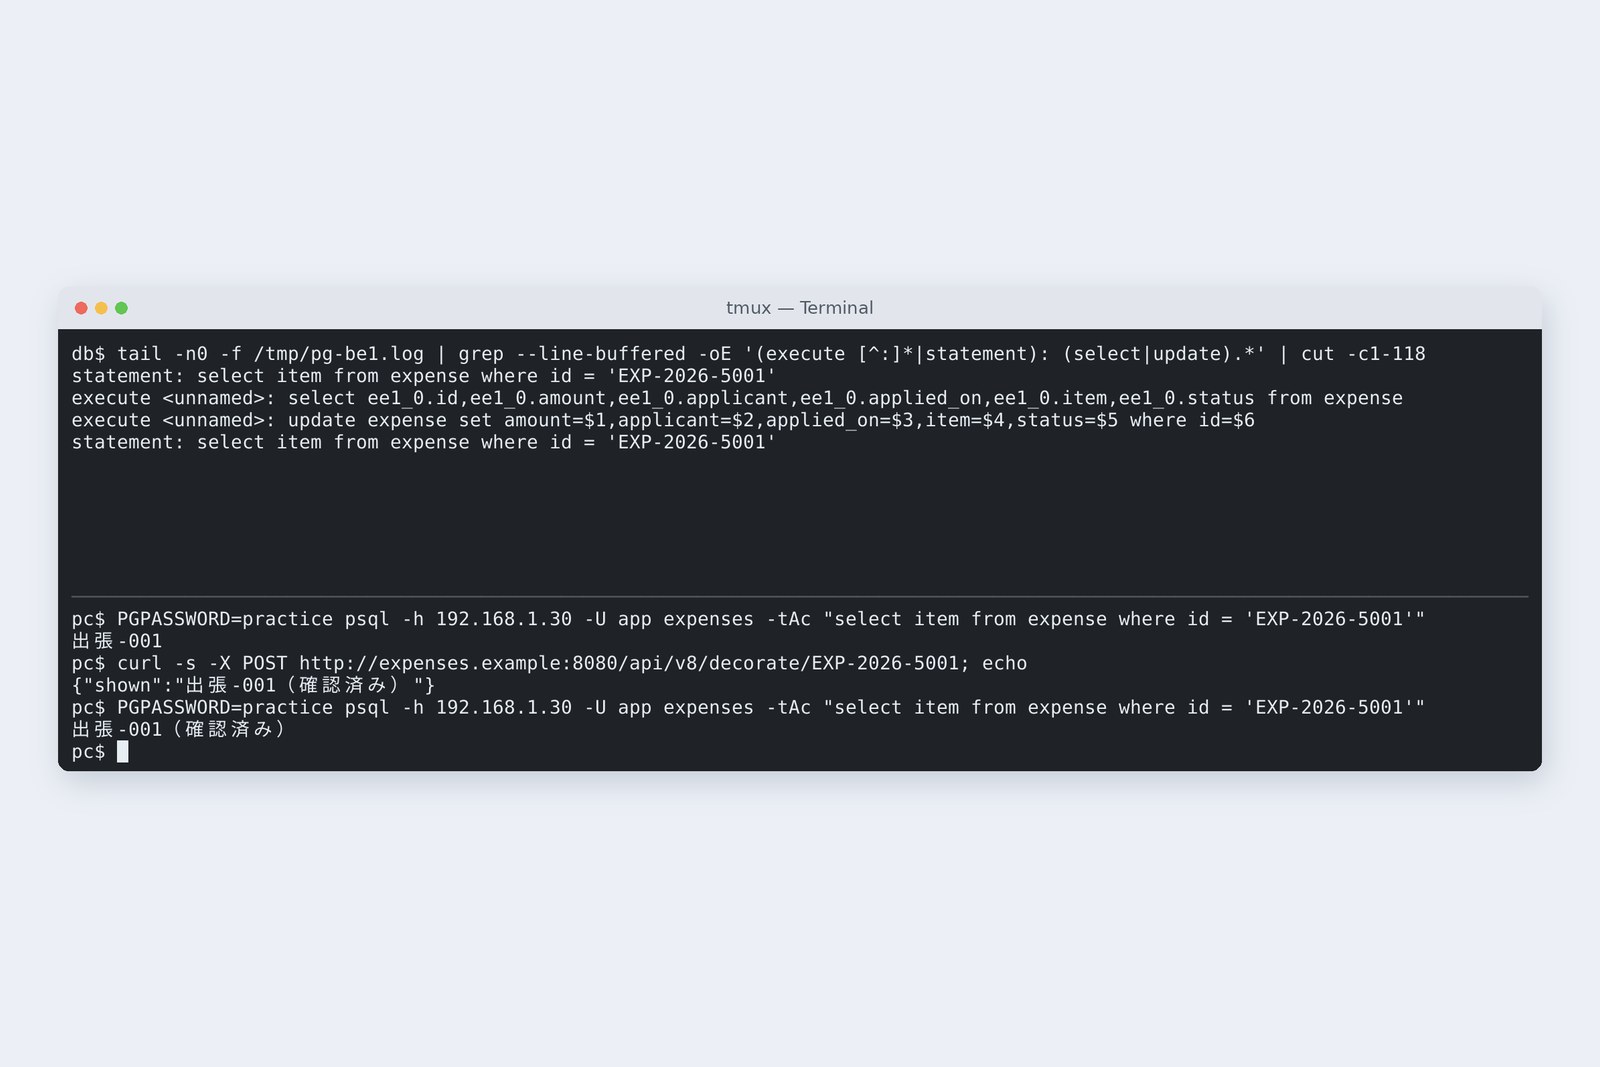
给 JPA 的负责人写了一个处理:“读出申请,为了显示在项目后面加上『(確認済み)』返回”。没打算写数据库,也没调用 save()。
# 负责人:只是读出来、为了显示改了名字。没有调用 save()
@Transactional  // 只是读出来、为了显示改了名字(本来是这么想的)
public String decorate(String id) {
    ExpenseEntity e = jpa.findById(id).orElseThrow();
    e.setItem(e.getItem() + "(確認済み)");
    return e.getItem();
}
# 调用前的数据库/调用窗口时的 SQL/调用后的数据库
  出張-001
  select ee1_0.id,ee1_0.amount,ee1_0.applicant,ee1_0.applied_on,ee1_0.item,ee1_0.status from expense ee1_0 where ee1_0.id=$1
  update expense set amount=$1,applicant=$2,applied_on=$3,item=$4,status=$5 where id=$6
  出張-001(確認済み)
数据库的项目被改写成了“出張-001(確認済み)”。JPA 把在事务中读出的 Entity 当作“持有物”来监视,提交时与读出时的副本比较,有变化就发出 update。而且发出的 update 不只是改了的项目,而是把所有列都重写了一遍。Entity 是“和数据库的行连着的东西”,不是可以为了显示而改写的东西。
JPA 的“持有物监视”与 open-in-view
open-in-view
加了 JPA 的应用,每次启动都会发出警告。
# 启动时的警告
spring.jpa.open-in-view is enabled by default. Therefore, database queries may be performed during view rendering. Explicitly configure spring.jpa.open-in-view to disable this warning
# 直接返回 Entity 的窗口(open-in-view 默认为 true)
  200  rows 103  SQL 104  62.7 ms
# 用 spring.jpa.open-in-view=false 启动时
  500  SQL 1
  Could not write JSON: Cannot lazily initialize collection of role 'example.expenses.v8.ExpenseEntity.lines' with key 'EXP-2026-0101' (no session)
Spring Boot 默认让监视(open-in-view)一直持续到写完回复。所以窗口直接返回 Entity 时,Jackson 一边写 JSON 一边碰明细,在窗口阶段发出了 104 条 SQL。设成 spring.jpa.open-in-view=false 后,监视在负责人的事务结束时就结束,在窗口碰明细的那一刻,因“no session”变成 500。
要说哪种更好,是设成 false,靠 500 及早发现。返回给画面的东西,在负责人里转换成别的形式(这一讲的 ClaimView),需要的明细在负责人里备齐。和第 5 讲“窗口只管 HTTP 的形式”是同一个思路。
MyBatis 的 #{} 与 ${}
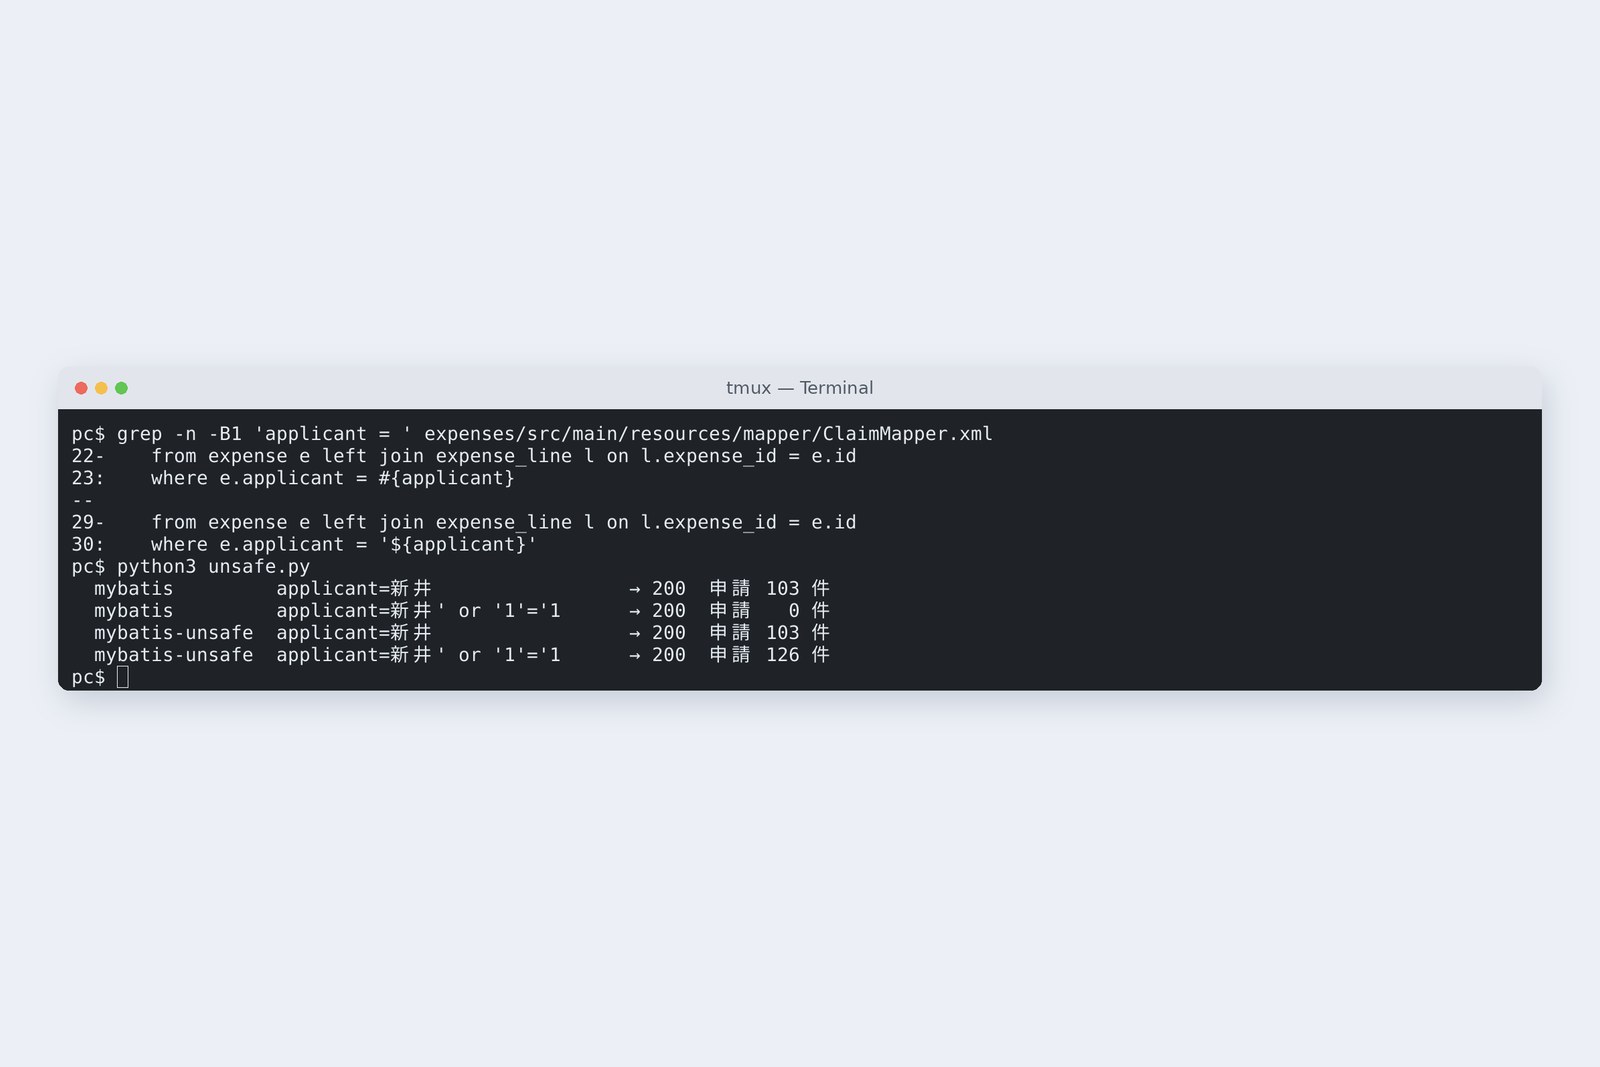
MyBatis 的 XML 里,放值的方式有两种:#{} 和 ${}。
# MyBatis 的两种写法
  #{}  where e.applicant = #{applicant}
  ${}  where e.applicant = '${applicant}'
# 传入同样的名字
  mybatis         新井' or '1'='1   → 200  0
  mybatis-unsafe  新井              → 200  103
  mybatis-unsafe  新井' or '1'='1   → 200  126
#{} 会变成第 4 讲的占位符(?),带引号的名字被当作“叫这个名字的人”,结果 0 件。${} 直接贴进 SQL 的文字里,和第 4 讲一样查出了所有人的 126 件。${} 只用于像排序列名那样、从允许清单里选出的值(第 4 讲第六章)。读旧的 MyBatis 代码时,请先搜索 ${。
工具的分量
# 工具配置(与第 7 讲的应用相比)
  第 7 讲: jar 24,340,548 字节、库 48、启动 3.667 s / 3.558 s / 3.651 s
  第 8 讲: jar 55,029,971 字节、库 75、启动 7.846 s / 8.0 s / 7.589 s
加上 JPA 和 MyBatis 之后,jar 从 24 MB 变成 55 MB,库从 48 个变成 75 个,启动从 3.6 秒延长到 7.8 秒左右。这一讲的应用同时装了 JPA 和 MyBatis,实际只会用其中一个。即便如此,Hibernate 在启动时要检查 Entity 并做准备,启动会变重。
选哪一个
| 工具 | 适合的场景 | 要注意的事 |
|---|---|---|
| JdbcClient | 表不多、想看着 SQL 开发、想细致地调性能 | 要自己写组装行的代码。SQL 散在 Java 里 |
| JPA | 表和对象形式接近、以增删改为主、表很多 | N+1、持有物监视(擅自 update)、open-in-view。一定要看送到数据库的 SQL |
| MyBatis | 复杂的 SQL、既有数据库、擅长 SQL 的团队(日本业务系统里很多) | ${}。在 XML 和 Java 两处来回 |
无论选哪一个,送到数据库的 SQL 都是“某人写的”。打开 SQL 日志数一数、不把 Entity 直接返回给画面、值一定用占位符。这三条换了工具也一样。本系列剩下的几讲,继续用能直接看到 SQL 的第 1 讲的 JdbcClient。同样的事用 JPA 或 MyBatis 也能写。
在自己的电脑上验证
| 想试的事 | 写法 |
|---|---|
| 把 Hibernate 生成的 SQL 输出到应用日志 | logging.level.org.hibernate.SQL=DEBUG |
| 把送到数据库的 SQL 全部写进日志(仅限练习用数据库) | alter system set log_statement = 'all'; |
| 把明细一起取回 | select distinct e from … left join fetch e.lines … |
| 让监视在负责人里结束 | spring.jpa.open-in-view=false |
| 查找 MyBatis 的字符串拼接 | grep -rn '\${' src/main/resources |
发现 N+1 最简单的方法,是打开一次列表画面,数数据库日志的行数。把件数从 3 件增加到 100 件,SQL 条数也跟着增加,就是 N+1。
结 — 一页总结与下一讲
- JdbcClient・JPA・MyBatis 能返回同样的答案。区别在于谁来写 SQL。
- 直接用 JPA 会 N+1。1 条就够的 SQL 变成 104 条,63.5 ms。用 join fetch 是 1 条,15.8 ms。
- JPA 监视读出的 Entity。不调用 save,改了也会 update。不要为了显示改写 Entity。
- open-in-view 设为 false。返回画面的形式在负责人里做。
- MyBatis 的 ${} 是字符串拼接。值用 #{}。
- 无论用什么工具,都要数一数送到数据库的 SQL。
新井打开 SQL 日志,开始觉得有点意思了。
古井好苗头。下一讲回到事务。新井和我同时修改同一件申请,会怎么样?古老的“后保存的人赢”问题。
参考
- Spring Framework — Using the JDBC Core Classes(JdbcClient)
- Spring Data JPA — Reference Documentation
- Hibernate ORM — Documentation
- Jakarta Persistence 3.2
- Spring Boot — SQL Databases(open-in-view)
- MyBatis 3 — Mapper XML Files(String Substitution)
- MyBatis Spring Boot Starter
记录是笔者于 2026 年 10 月 31 日在云端 Linux(Ubuntu 24.04,内核 6.18)上,用 Spring Boot 4.1.2(Hibernate 7.4、Spring Data JPA 4.1、MyBatis 3.5.19、mybatis-spring-boot 4.1.0)、OpenJDK 25.0.4、PostgreSQL 16.15 取得的。申请服务器和数据库服务器是在一台机器里建立的不同网络空间(network namespace),往返约 0.04 ms。时间是 5 次的中间值(照片是 1 次的值),每次运行都会变。行数不计空行。表中的数字和输出,全部是从当时命令输出中读取的实际值。登场人物均为虚构。
古法后端入门 第8讲 — 数据库访问 / 2026.10