Dev Guide / 2026 ・ No.04
在本地运行大模型
从 CUDA 与 Metal 的区别,到用 LM Studio 跑起 Qwen3.8-27B
发布
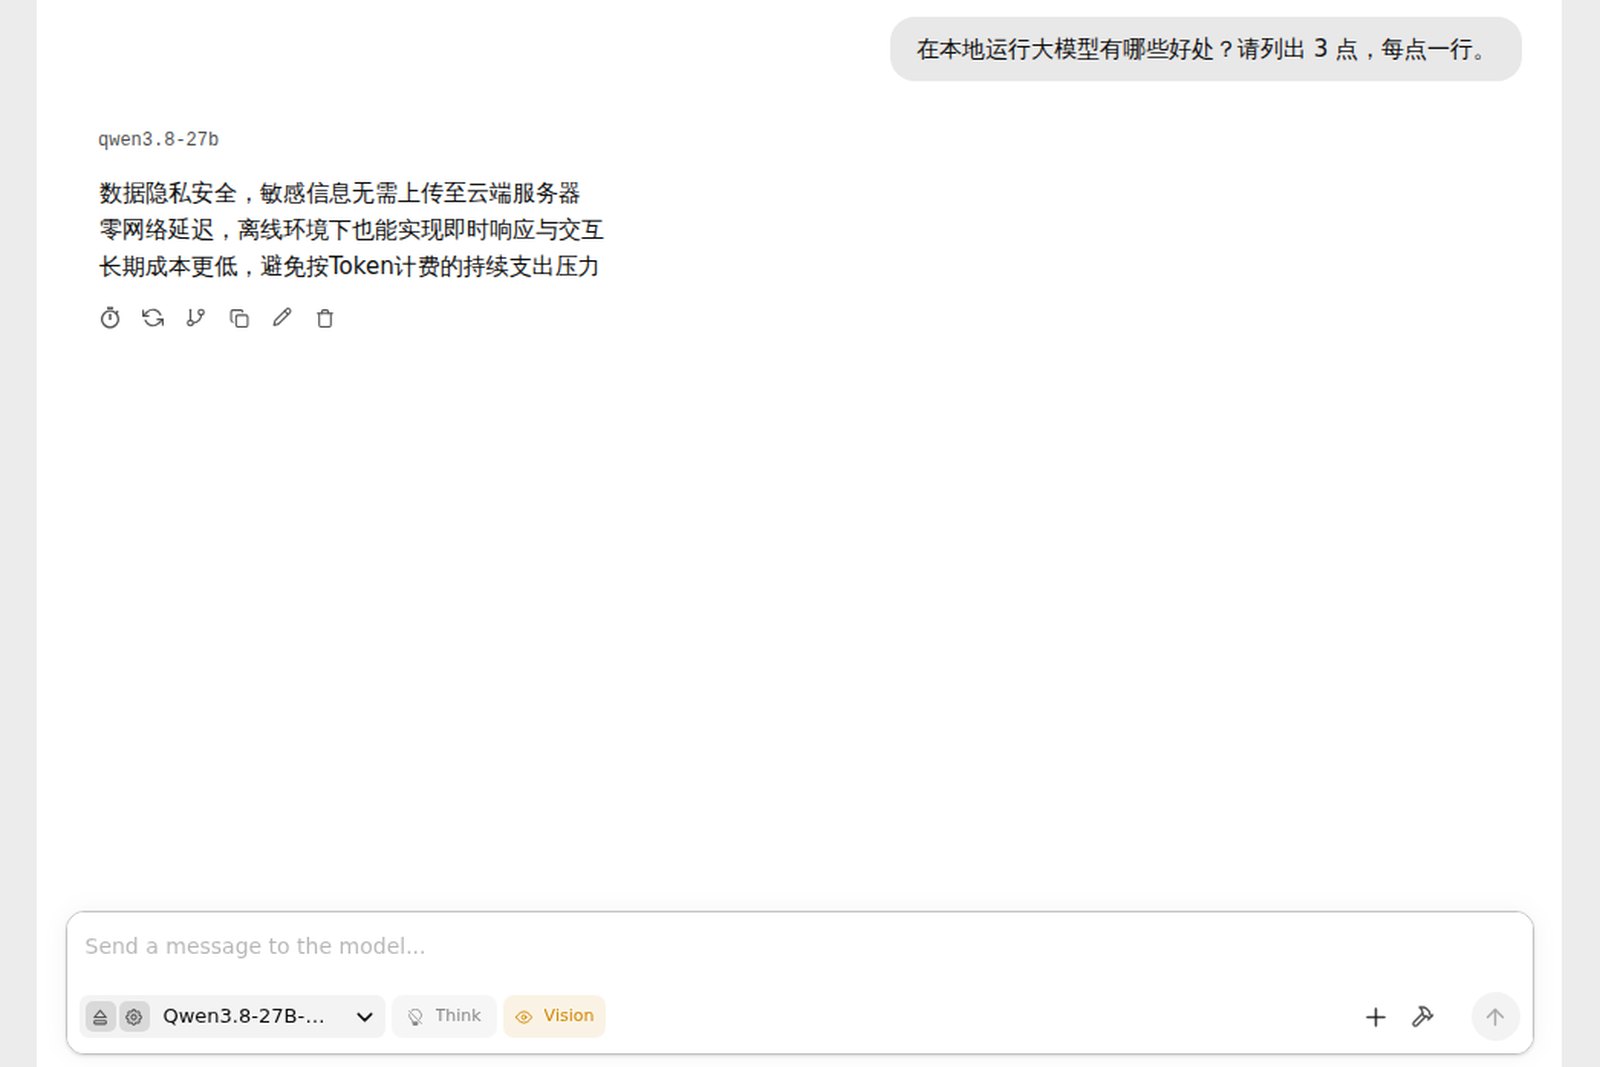
像 ChatGPT 这样的 AI,通常运行在互联网另一端的服务器上。
但现在,也可以把公开的模型下载下来,只在自己的电脑里运行。
本文先梳理“有哪些技术体系”“Windows・Mac・Linux 能用什么”“27B、Q4_K_M 是什么意思”,
再介绍文本、图像、声音、OCR、翻译方面实用的模型,最后配截图讲解用 LM Studio 运行 Qwen3.8-27B 的步骤。
为什么要在本地运行
在本地运行,就是把模型的权重(训练得到的一大堆数值)作为文件放在自己手边,用自己机器的 GPU 或 CPU 来计算。提问和回答都不会离开这台机器。
| 本地 | 云端 AI 服务 | |
|---|---|---|
| 数据 | 不出机器,适合处理机密和个人信息 | 发送到服务商 |
| 费用 | 只有机器和电费,随便用 | 月费或按量计费 |
| 离线 | 可以用 | 不能用 |
| 聪明程度 | 上限取决于机器内存 | 能用最前沿的超大模型 |
| 麻烦程度 | 自己选模型、自己更新 | 基本不用管 |
本地的短板是“能装下的模型大小有上限”。反过来说,能否选到与自己机器内存相匹配的模型,几乎决定了本地部署的成败。本文前半部分讲的就是怎么选。
按技术体系分类 ── CUDA・Metal・ROCm・CPU
把本地运行的结构从上到下分成“应用”“推理引擎”“GPU 指令体系”“内存”几层,就容易看清了。常说的“CUDA 系”“Metal 系”,指的是下面两层的不同。
应用相同,区别在下层
推理引擎 llama.cpp 支持所有体系,所以 LM Studio 和 Ollama 在哪种机器上都能运行
| 体系 | 代表机器 | 优点 | 缺点 |
|---|---|---|---|
| NVIDIA・CUDA | 装有 GeForce RTX 的 Windows・Linux 机器 | 支持的软件最多,文生图、语音、训练都能跑,速度快 | 显存只有 8〜32GB,大模型放不下 |
| Apple・Metal / MPS / MLX | M1〜M5 的 Mac | CPU 和 GPU 共享内存(统一内存),64GB、128GB 的 Mac 能放下大模型,安静省电 | 算力比同价位 NVIDIA 慢,CUDA 专用软件不能跑 |
| AMD・ROCm / Vulkan | Radeon、搭载 Ryzen AI Max 的机器 | 按显存算比较便宜,Ryzen AI Max 有大容量共享内存 | 软件支持比 CUDA 少,因系统和型号差别大 |
| Intel・oneAPI / Vulkan | Arc 显卡、Core Ultra | 价格亲民 | 支持的软件少 |
| 纯 CPU | 没有 GPU 的电脑、服务器 | 哪里都能跑 | 慢,适合小模型 |
- CUDA 是让 NVIDIA GPU 用于计算的平台。以 PyTorch 为首,几乎所有 AI 软件都最先支持它。
- Metal 是 Apple 的 GPU 平台,MPS 是在其上运行 PyTorch 的部分,MLX 是 Apple 为 Apple Silicon 打造的机器学习框架。在 Mac 上,MLX 版模型通常最快。
- Vulkan 是不分厂商的 GPU 接口,llama.cpp 在 AMD、Intel 显卡上可以用它运行。
- NPU(Copilot+ PC、Apple 的神经网络引擎)也是为 AI 准备的,但截至 2026 年秋,在自由运行大语言模型方面还不是主角。
Windows・Mac・Linux 的选择
| 用途 | Windows | Mac(Apple Silicon) | Linux |
|---|---|---|---|
| 用图形界面聊天 | LM Studio・Ollama | LM Studio(支持 MLX)・Ollama | LM Studio(AppImage) |
| 命令行・常驻后台 | Ollama・llama.cpp・lms | Ollama・llama.cpp・mlx-lm・lms | Ollama・llama.cpp・lms・llmster |
| 面向多人的正式服务 | 在 WSL2 上跑 vLLM | (不适合) | vLLM・SGLang(面向 NVIDIA) |
| 文生图 | ComfyUI | ComfyUI・Draw Things | ComfyUI |
| 声音・OCR・翻译 | 各模型的官方仓库(Python)、ComfyUI 节点;能在 Ollama・LM Studio 里跑的就用它们 | ||
- LM Studio … 在界面里就能完成搜索、下载、加载、聊天,甚至开 API 服务器。Mac 支持 Apple Silicon,Windows 支持 x86 和 ARM64(骁龙),Linux 支持 x86 和 ARM64(以下载页为准)。本文的步骤就用它。
- Ollama … 一行 ollama run 模型名 就能跑的经典工具。Mac 和 Windows 有图形界面的应用,Linux 用命令安装。
- llama.cpp … 在 LM Studio、Ollama 内部运行的推理引擎本体,适合想精细调整的人。
- vLLM … 面向多人同时访问的高速服务引擎,基本是 Linux+NVIDIA。
术语 ── 27B・Q4_K_M・A3B 等是什么意思
模型名称和下载页面上排着一串像符号一样的词。看懂它们,就能马上判断自己的机器能不能跑。
| 术语 | 含义 | 例子 |
|---|---|---|
| ◯B | 参数(权重)的数量。B 是 billion=10 亿。越多越聪明,但内存和计算量也越大 | 27B=270 亿,4B=40 亿 |
| E◯B | 实际参与计算的“有效”参数量(Gemma 小型版) | Gemma 4 E4B |
| ◯B-A◯B(MoE) | 切换“专家”的 MoE 结构。前面是总量,A 后面是每个 token 实际激活的部分。内存看总量,速度看激活量 | Qwen3.6-35B-A3B(总量 35B,激活 3B) |
| Dense(稠密) | 每次都用全部参数。同等大小通常比 MoE 更聪明,但更慢 | Qwen3.8-27B |
| 量化 | 减少权重的位数来缩小体积。BF16(16 比特)→ 8 比特 → 4 比特,越小精度略降 | Q8_0、Q4_K_M |
| Q4_K_M | llama.cpp 的一种量化方式,约 4〜5 比特,体积与精度平衡好,最常用 | 27B 为 16.8GB |
| MXFP4・NVFP4 | 新的 4 比特格式。gpt-oss 以 MXFP4 发布,NVFP4 面向 NVIDIA 新显卡 | gpt-oss-20b |
| GGUF | llama.cpp 用的文件格式,LM Studio・Ollama 使用,一个文件搞定 | ◯◯-Q4_K_M.gguf |
| MLX | Apple Silicon 专用格式,在 Mac 上通常更快 | ◯◯-MLX-4bit |
| safetensors | 原始权重的格式,PyTorch・vLLM・ComfyUI 等使用 | 官方仓库 |
| 上下文长度 | 一次能记住的长度(token 数)。越长,KV 缓存占用的内存越多 | 256K(262,144) |
| token | 把文字切碎后的单位。中文大约 1〜2 个字一个 token | |
| tok/s | 每秒生成的 token 数=生成速度。比阅读速度快就算流畅 | 20 tok/s |
| 显存/统一内存 | GPU 专用的内存/Mac 上 CPU 与 GPU 共享的内存。模型就放在这里 | RTX 4090 为 24GB |
| GPU 卸载 | 模型的各层中有多少层放到 GPU 上。全部放上去最快 | |
| -Instruct・-it | 为对话调整过的版本,一般用这个(Base 是原始版) | gemma-4-31B-it |
| Thinking | 回答前先输出思考过程,更聪明但更花时间 | Qwen3.8 可切换 |
| VL・Vision | 能看图的模型。GGUF 版会附带一个 mmproj 文件 | mmproj-◯◯.gguf |
| 许可证 | 能否商用。Apache 2.0・MIT 可以商用,也有自定义、研究用、非商用的 |
内存与速度的估算
需要多少内存,大致可以用“参数量 × 比特数 ÷ 8”来算。下图是本文所用 Qwen3.8-27B 的实际文件大小。
27B 的模型有多少 GB
文件大小取自 Hugging Face 上 lmstudio-community/Qwen3.8-27B-GGUF(BF16 按 27.78B×2 字节计算)
速度则几乎由从内存读取权重的速度(带宽)决定,因为每生成一个 token,都要把权重从头读一遍。
速度 ≒ 内存带宽 ÷ 模型大小
理论上限。实际会更慢;Mac 上的 MLX 版或 MTP(多 token 预测)可以快一些
| 机器内存 | 能轻松跑的大小 | 推荐例子 |
|---|---|---|
| 8GB(无 GPU 的笔记本等) | 2〜4B | Gemma 4 E2B・E4B |
| 显存 12〜16GB/Mac 16〜24GB | 〜12B,或 20B 级 MoE | Gemma 4 12B、gpt-oss-20b |
| 显存 24〜32GB/Mac 32〜48GB | 27〜35B 的 4 比特版 | Qwen3.8-27B、Gemma 4 26B-A4B・31B |
| Mac 64GB 以上 | 35B 的 8 比特版、更大的 MoE | Qwen3.6-35B-A3B(8 比特) |
| Mac 128GB 以上等 | 100B 级 MoE | gpt-oss-120b |
Mac 并不能把全部内存都给 GPU,默认大约三分之二到四分之三。还要给系统和其他应用留空间,所以模型文件占内存一半多一点,就比较稳妥。
当下实用的模型(2026 年 10 月)
以下均在 Hugging Face 官方页面核对过发布时间、参数量和许可证。“商用”一栏中,Apache 2.0、MIT 等允许商用的标〇(具体条件请查看各许可证)。
写作与对话(LLM)
| 模型 | 大小 | 4 比特约 | 商用 | 一句话 |
|---|---|---|---|---|
| Qwen3.8-27B(阿里・2026 年 8 月) | 27B(稠密) | 17GB | 〇 | 同尺寸顶级水平,能看图和视频,256K |
| Gemma 4(Google・2026 年 3 月起) | E2B・E4B・12B・26B-A4B・31B | E4B 几 GB〜31B 约 20GB | 〇 | 尺寸可选,小型适合笔记本 |
| Qwen3.6-35B-A3B(2026 年 4 月) | 35B(MoE,激活 3B) | 约 24GB | 〇 | 激活量小,所以快 |
| gpt-oss-20b/120b(OpenAI・2025 年 8 月) | 21B・117B(MoE) | 约 14GB/约 65GB | 〇 | 以 MXFP4 发布,16GB 也能跑 |
文生图
| 模型 | 大小 | 商用 | 一句话 |
|---|---|---|---|
| Z-Image-Turbo(阿里通义・2025 年 11 月) | 6B | 〇 | 8 步出图,快。16GB 级显卡就实用,擅长写实 |
| FLUX.2 [klein] 4B/9B(Black Forest Labs・2026 年 1 月) | 4B・9B | 仅 4B 〇 | 轻量,还能编辑图片。9B 为非商用许可 |
| Qwen-Image-2512(2025 年 12 月) | 20B | 〇 | 擅长图中文字(中英文)。较重,用量化版 |
| Qwen-Image-2.1(2026 年 9 月) | 7B | 研究用 | 新且轻,但许可证面向研究,需注意 |
| SDXL(Stability AI・2023 年) | 约 2.6B | 〇(有条件) | 老但轻,LoRA 等追加数据极多 |
声音克隆(语音合成)
| 模型 | 大小 | 商用 | 一句话 |
|---|---|---|---|
| Qwen3-TTS(阿里・2026 年 1 月) | 0.6B・1.7B | 〇 | 3 秒声音即可克隆,支持中日英等 10 种语言 |
| VoxCPM2(OpenBMB・2026 年 4 月) | 2B | 〇 | 30 种语言・48kHz,还能用文字描述来设计声音 |
| IndexTTS-2.5(哔哩哔哩・2026 年 8 月) | — | 自有许可 | 擅长情感和时长控制,2.5 起支持日语 |
| Fun-CosyVoice3-0.5B(阿里・2025 年 12 月) | 0.5B | 〇 | 轻快 |
| GPT-SoVITS(开源项目) | — | 〇(MIT) | 用 1 分钟左右的声音微调,社区用户多 |
声音克隆请只用于取得本人同意的声音。用他人的声音生成语音并冒充本人发布,可能构成诈骗或侵权。
OCR(识别图片・PDF 中的文字)
| 模型 | 大小 | 商用 | 一句话 |
|---|---|---|---|
| PaddleOCR-VL-1.6(百度・2026 年 5 月) | 0.9B | 〇 | 表格、公式、图表都能识别,OmniDocBench v1.6 达 96.33%(官方公布) |
| GLM-OCR(智谱 Z.ai・2026 年 1 月) | 约 0.9B | 〇(MIT) | 小而快,Ollama 也能跑 |
| DeepSeek-OCR-2(2026 年 1 月) | 3B | 〇 | 用很少的 token 读长文档 |
| MinerU2.5-Pro(OpenDataLab・2026 年 5 月) | 1.2B | 〇 | 适合把 PDF 转成 Markdown |
| olmOCR-2(Ai2・2025 年 10 月) | 7B | 〇 | 适合批量处理大量 PDF |
翻译
| 模型 | 大小 | 商用 | 一句话 |
|---|---|---|---|
| Hy-MT2(腾讯混元・2026 年 5 月) | 1.8B・7B・30B-A3B | 〇 | 33 种语言,有官方 GGUF,1.8B 笔记本也能跑 |
| TranslateGemma(Google・2026 年 1 月) | 4B・12B・27B | 〇(Gemma 条款) | 基于 Gemma 的翻译专用版 |
| PLaMo 2 Translate(PFN・2025 年 5 月) | 约 10B | 有条件 | 专攻日英互译 |
| NLLB-200(Meta・2022 年) | 0.6〜3.3B | 非商用 | 200 种语言,老但擅长小语种 |
翻译交给上面的 LLM(Qwen3.8、Gemma 4)也足够好。专用模型的优势在于“小而快”。
只选一个:Qwen3.8-27B
如果只选一个既适合本地部署、精度又高的模型,那就是 2026 年 8 月发布的 Qwen3.8-27B。
- 精度高 … 官方对比表中,它在各方面都超过上一代 Qwen3.6-27B,写作、代码、资料调研、智能体任务都属于同尺寸顶级(例:SWE-bench Pro 61.7〔上一代 53.5〕、GPQA Diamond 89.2)。
- 刚好装得下 … 4 比特(Q4_K_M)为 16.8GB,24GB 显存的显卡(RTX 3090・4090 等)或内存 32GB 以上的 Mac 可以直接装下。
- 能看图 … 可以传照片、图表、PDF 截图来提问。上下文 262,144 token。
- Apache 2.0 … 商用也可以自由使用。
- 到处能跑 … 有 GGUF 版和 MLX 版,LM Studio、Ollama(ollama run qwen3.8)、llama.cpp、vLLM 都能用。
内存在 16GB 以下的话,用同样的步骤选择 Gemma 4 12B(约 8GB)或 Gemma 4 E4B 即可。只需换个搜索词,后面的操作完全一样。
步骤 1:安装 LM Studio
截图使用的是 Linux 版 LM Studio 0.4.25。Mac、Windows 版的界面相同,只是窗口边框和菜单不同。
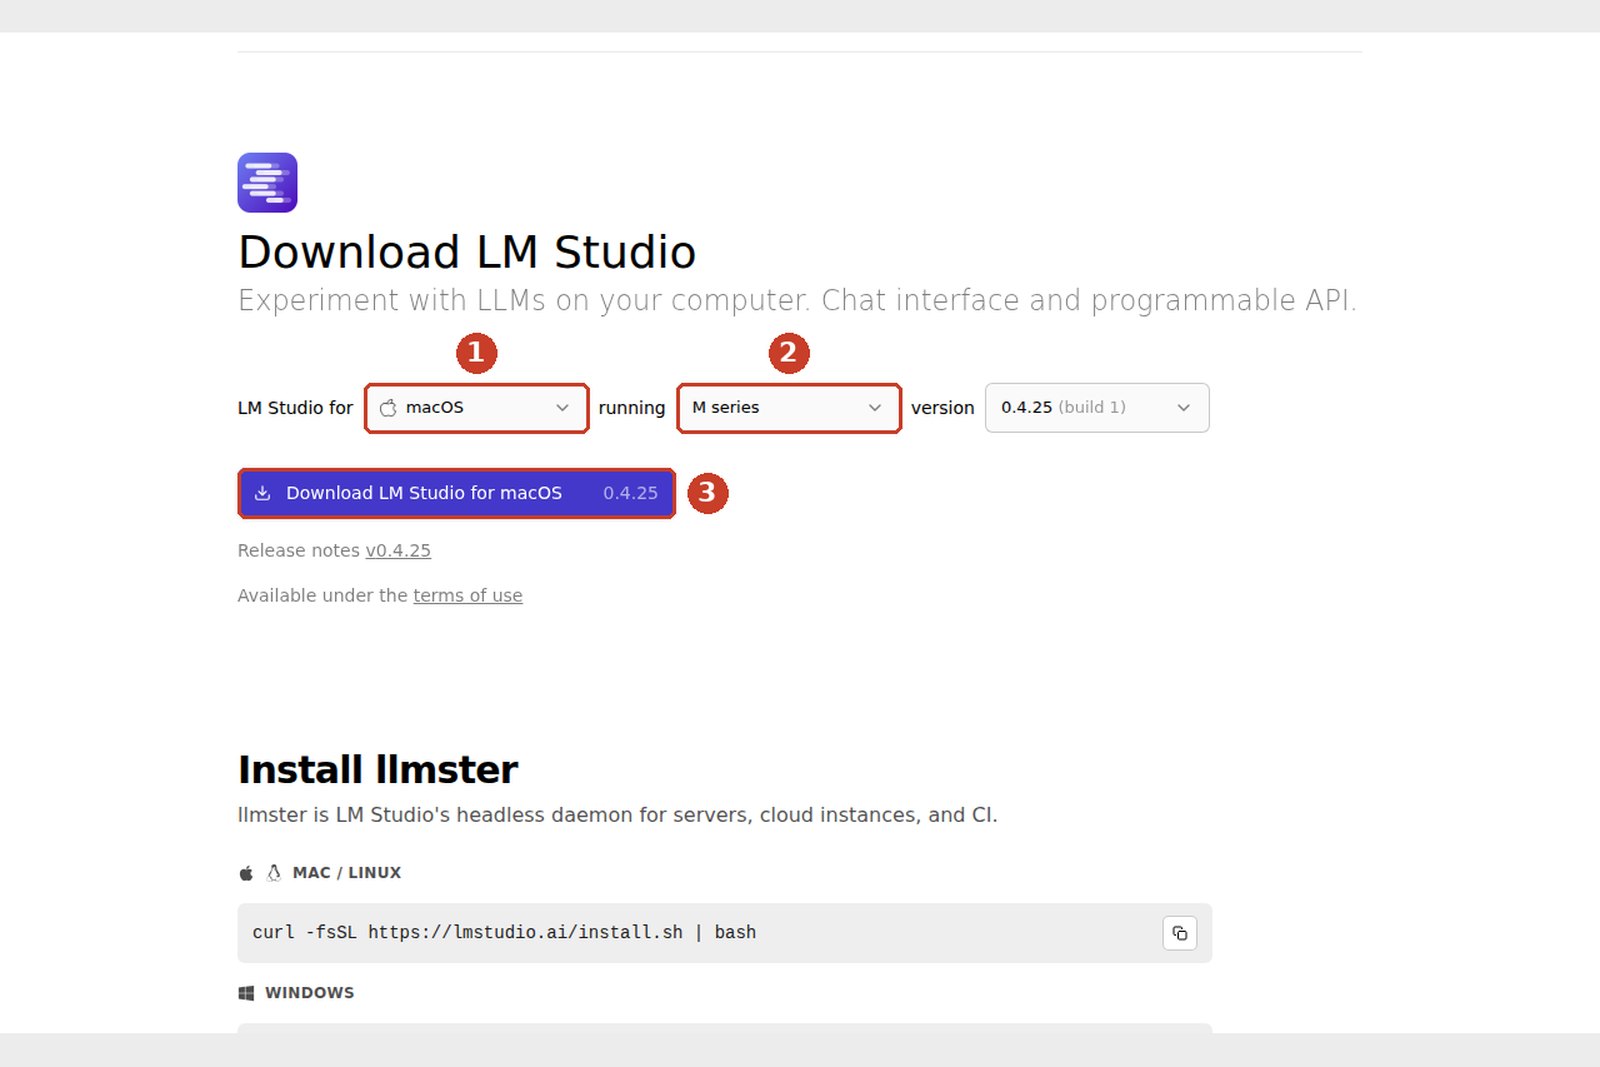
- 打开 lmstudio.ai/download。页面顶部会出现另一款产品“LM Studio Bionic”(智能体应用),本文要用的是下面的 Download LM Studio。
- Mac:打开 dmg,把 LM Studio 拖进“应用程序”。Windows:运行安装程序。Linux:给 AppImage 加上执行权限(chmod +x)后启动。
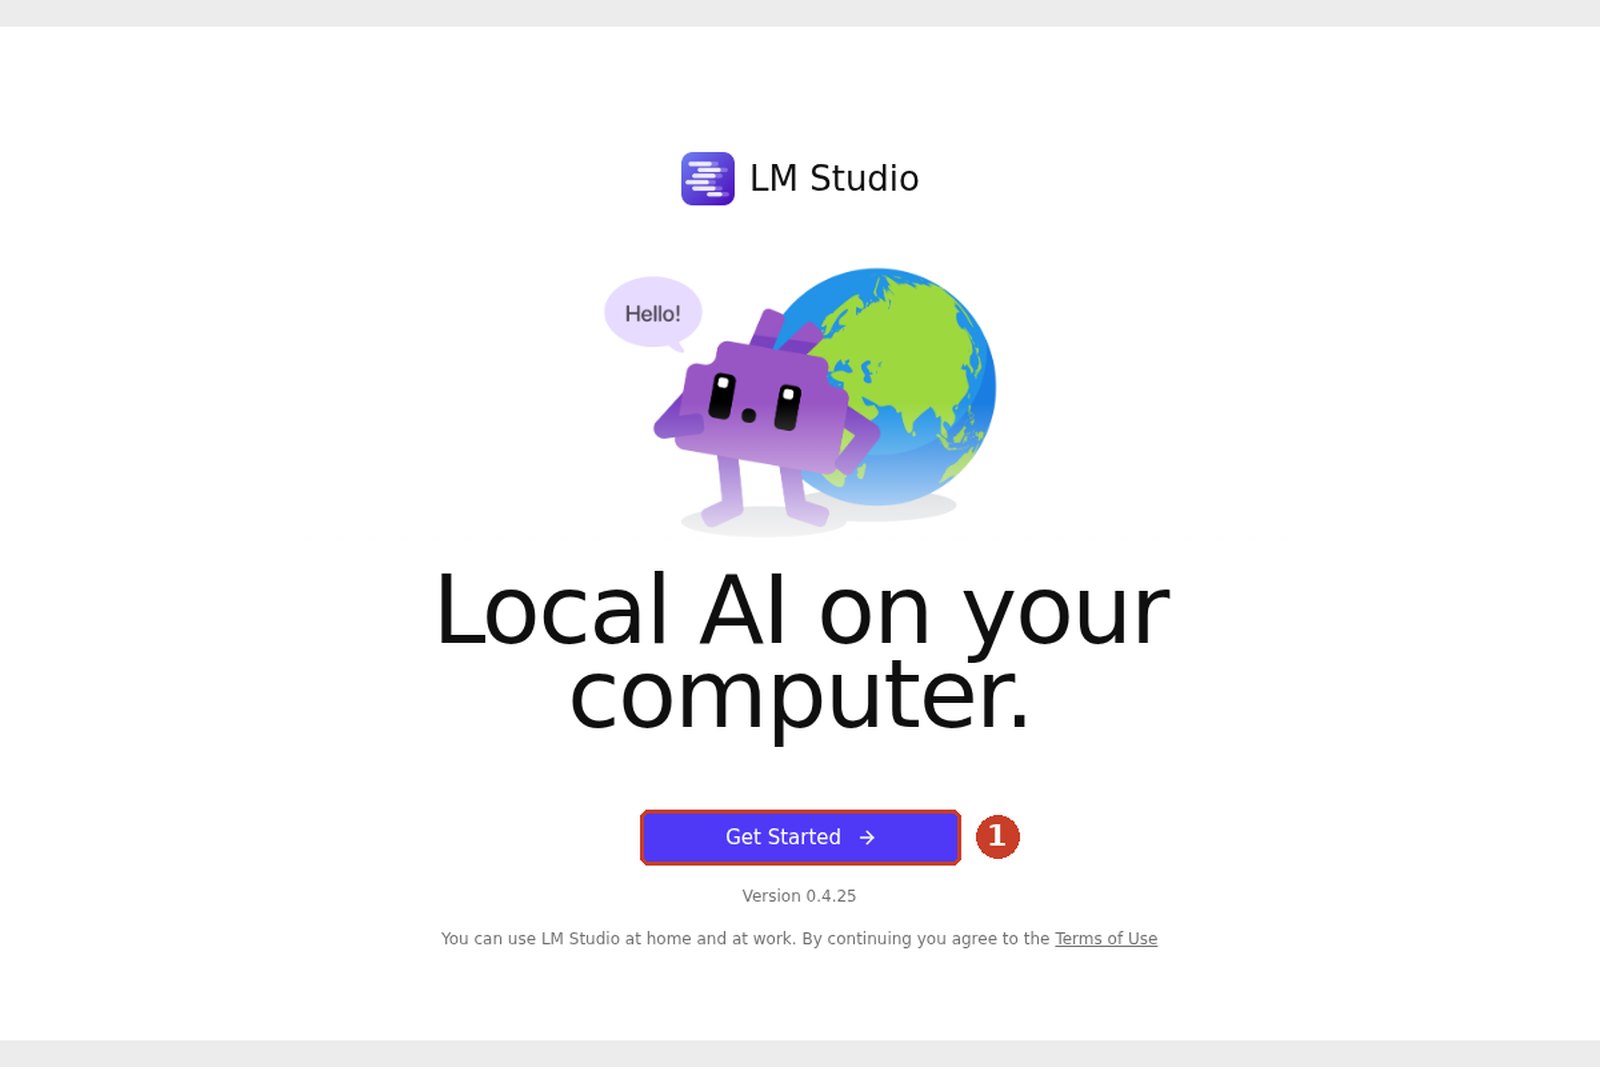
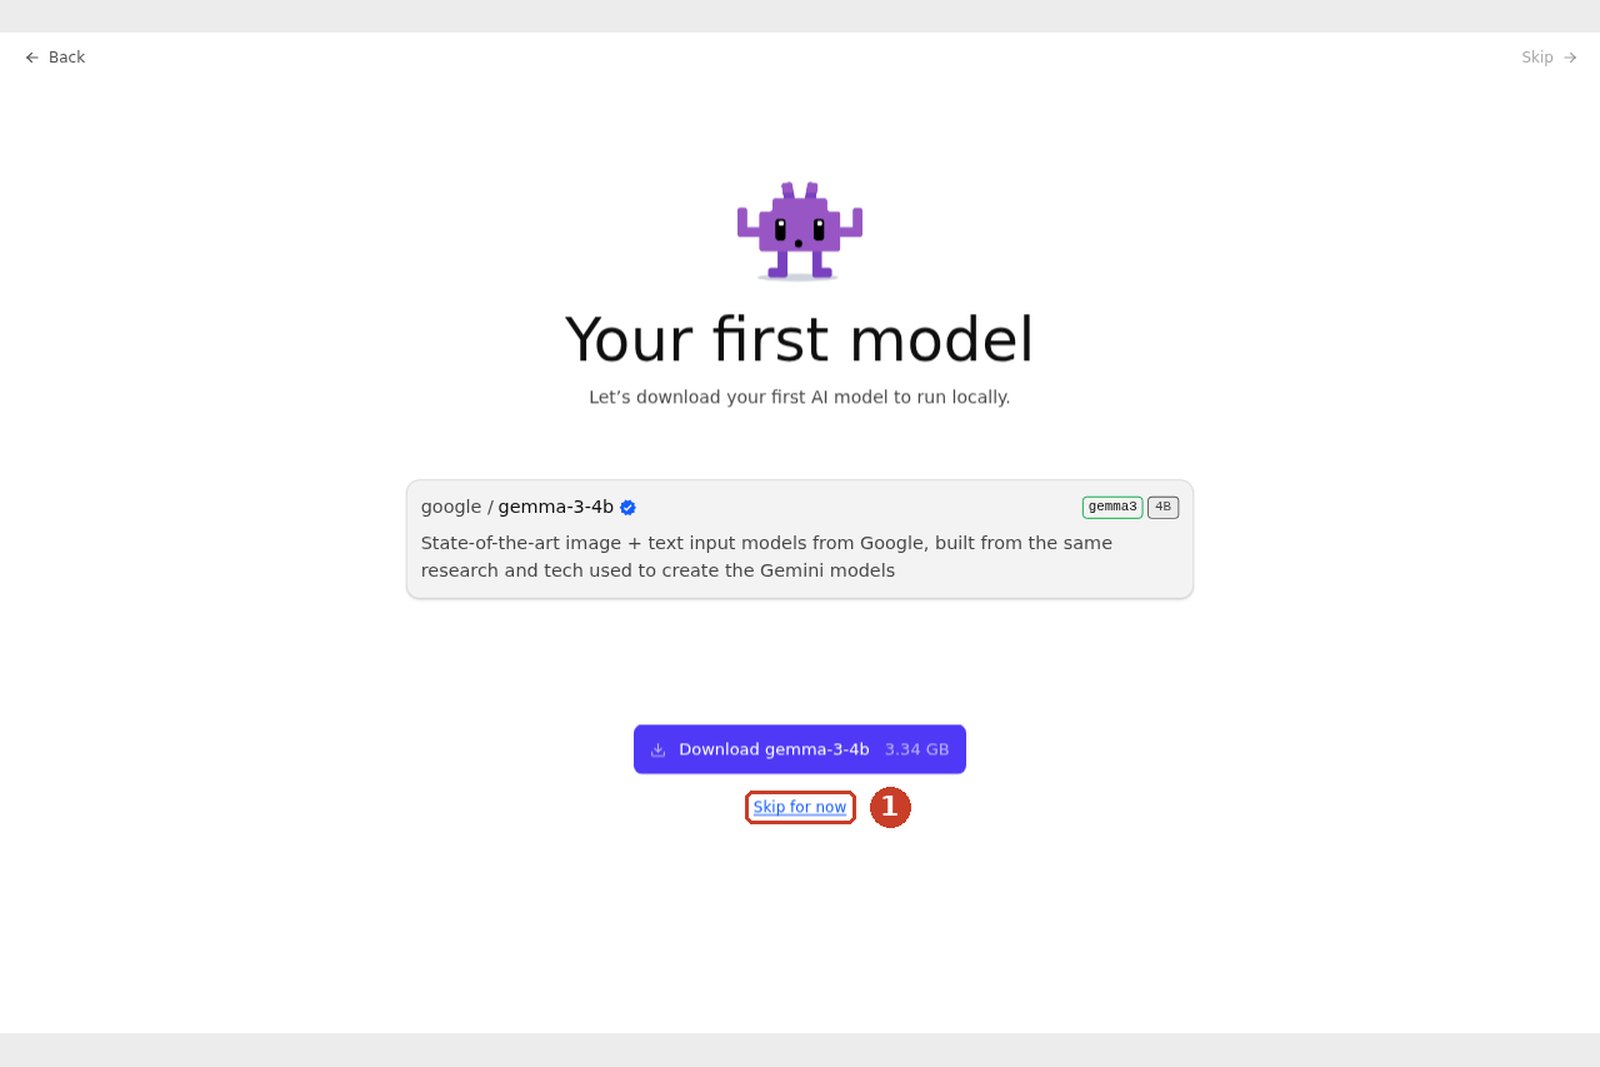
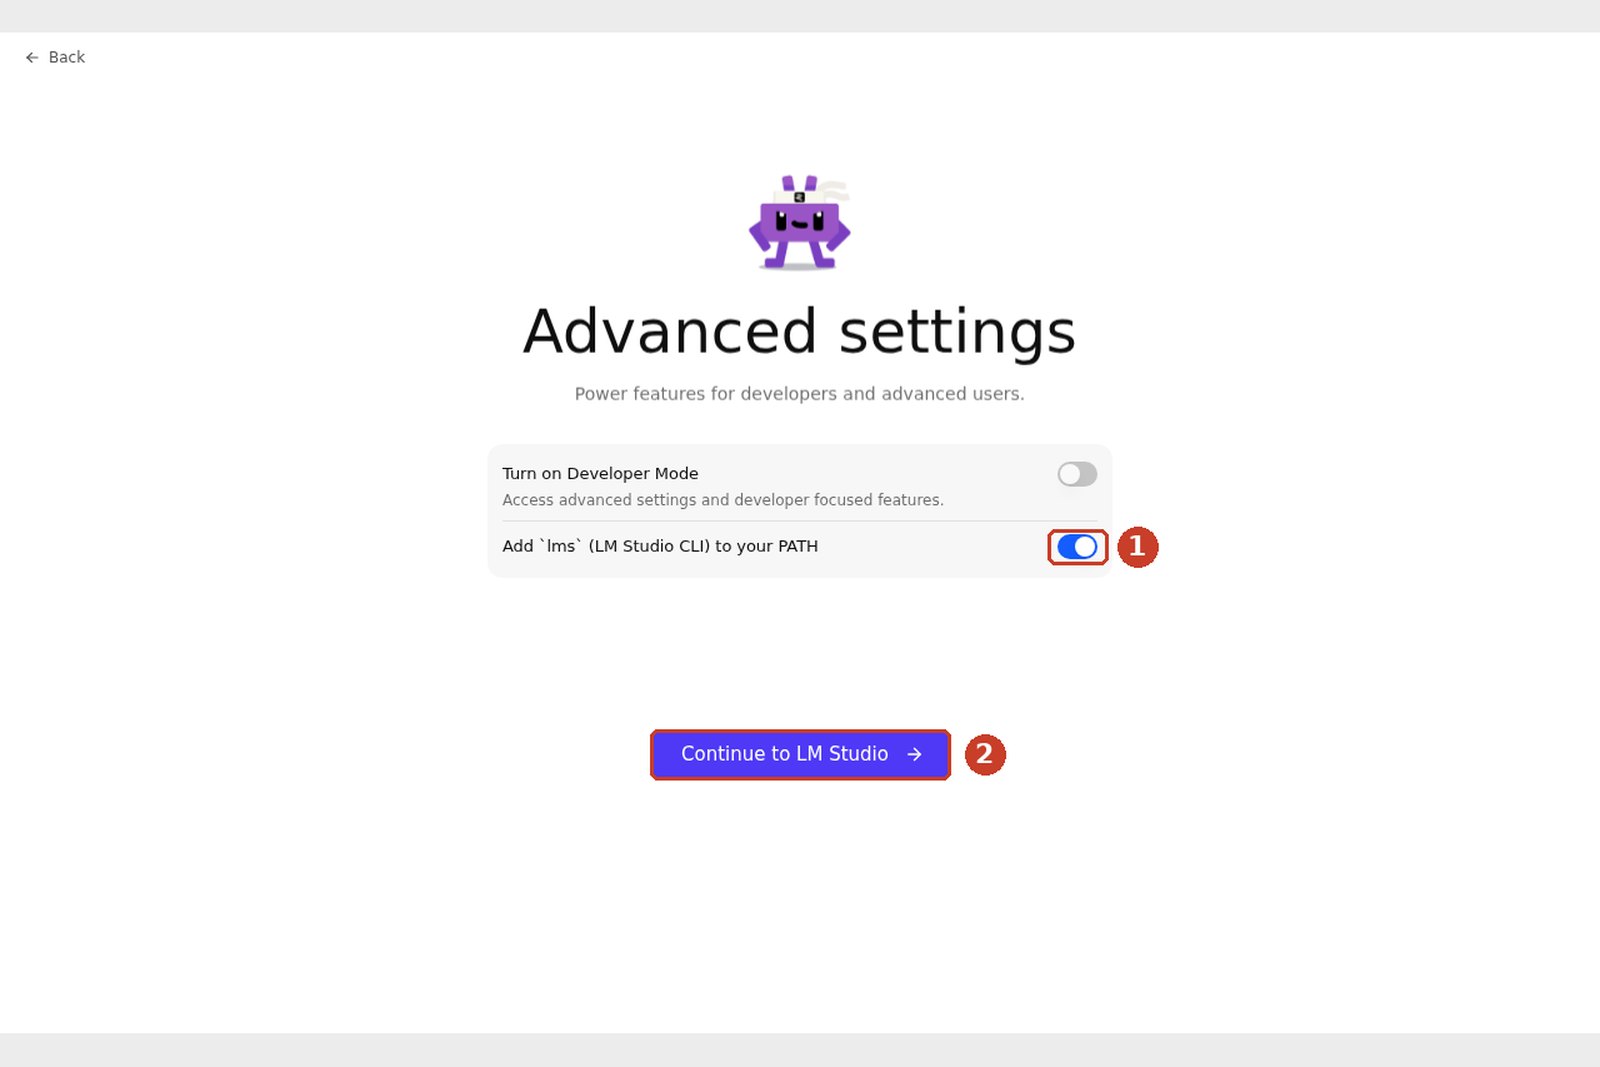
不需要登录,准备工作到此结束。
步骤 2:下载 Qwen3.8-27B
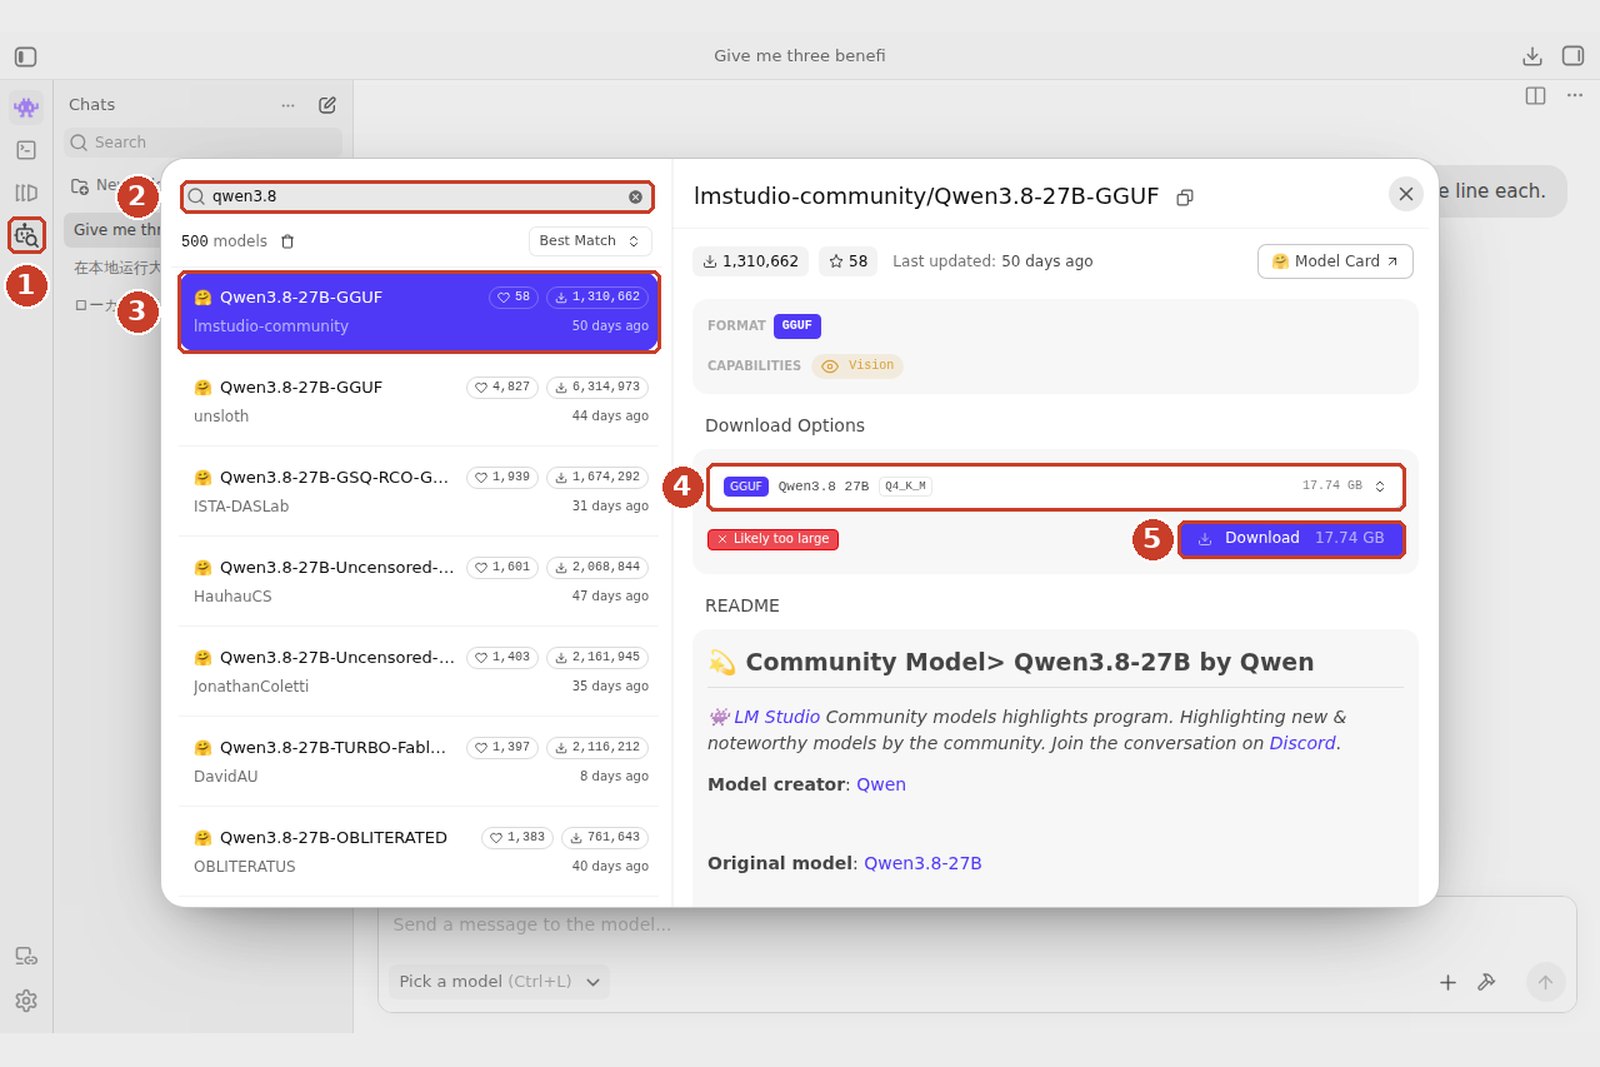
- Mac 用户在 ③ 选择 lmstudio-community/Qwen3.8-27B-MLX-4bit,就是面向 Apple Silicon 的 MLX 版,速度更快。
- 量化拿不准就选 Q4_K_M。内存有余量的话,Q6_K(22.4GB)或 Q8_0(29.0GB)精度会略高。
- 用于看图的 mmproj(约 0.9GB)会一起下载,合计约 17.7GB。
- 红色的 Likely too large 是“这台机器内存可能不够”的提示。截图机只有 8GB 内存所以出现了,24GB 显卡或 32GB 的 Mac 上不会出现。
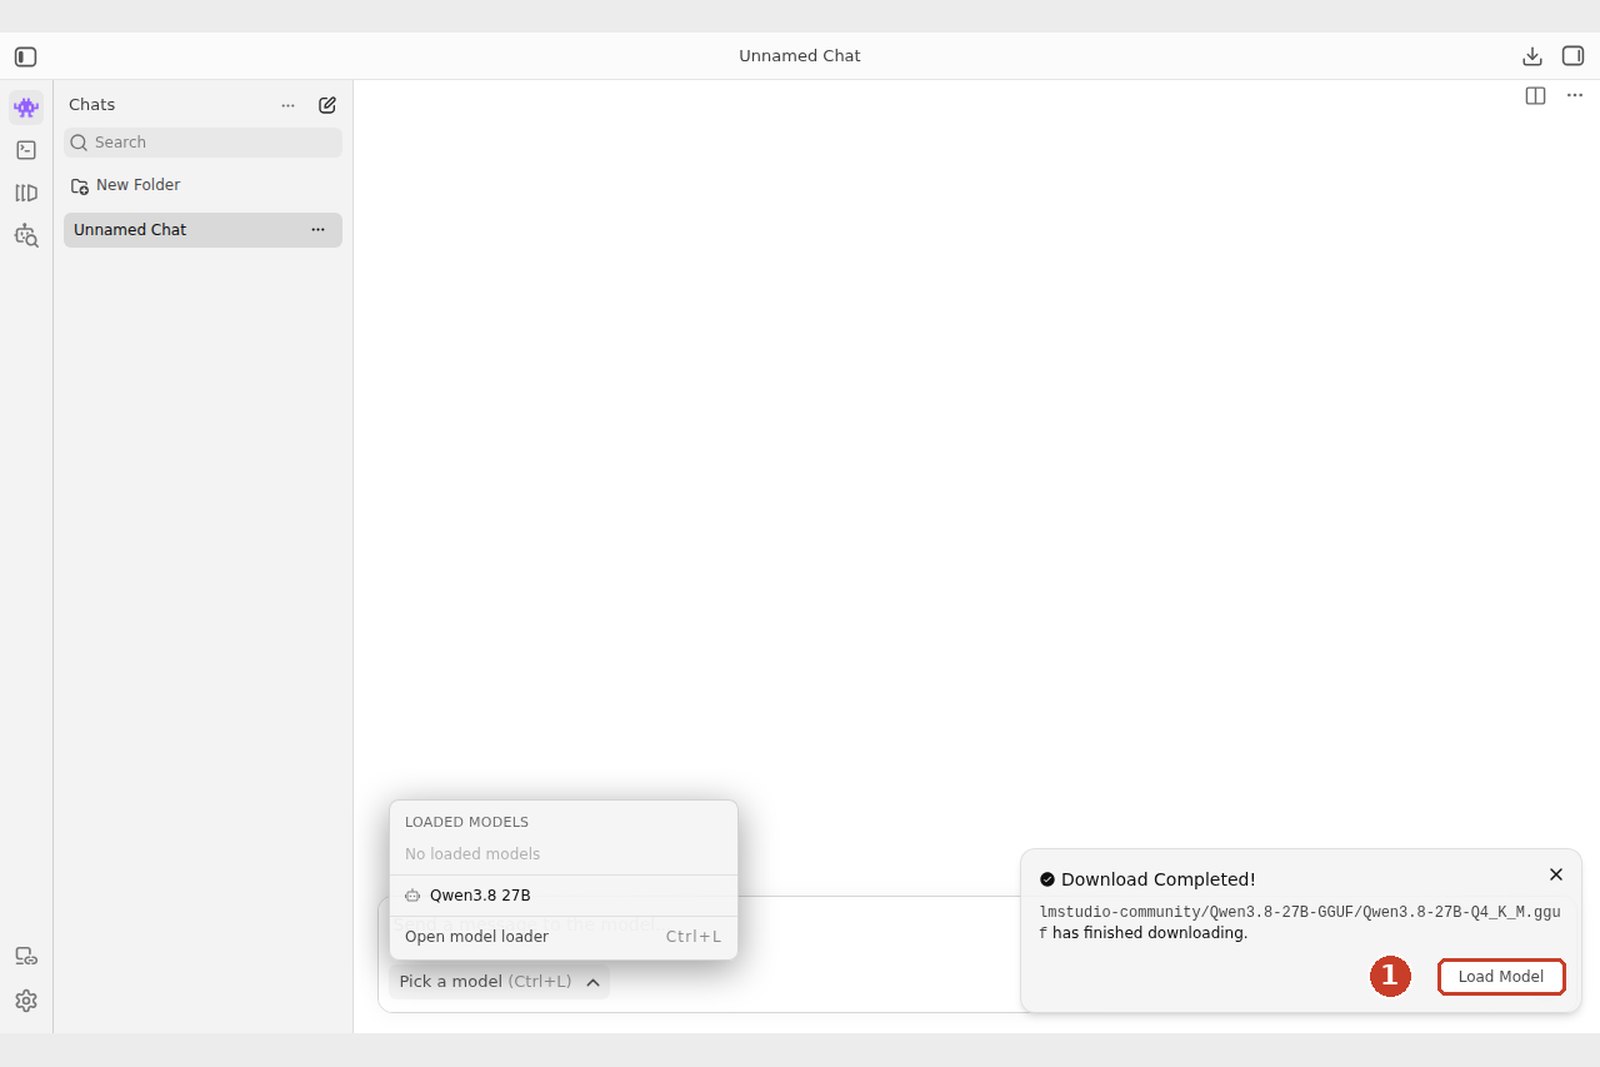
步骤 3:加载并对话
在聊天画面下方的“Pick a model”(Mac 按 ⌘+L,Windows・Linux 按 Ctrl+L)选择模型,会打开加载设置。
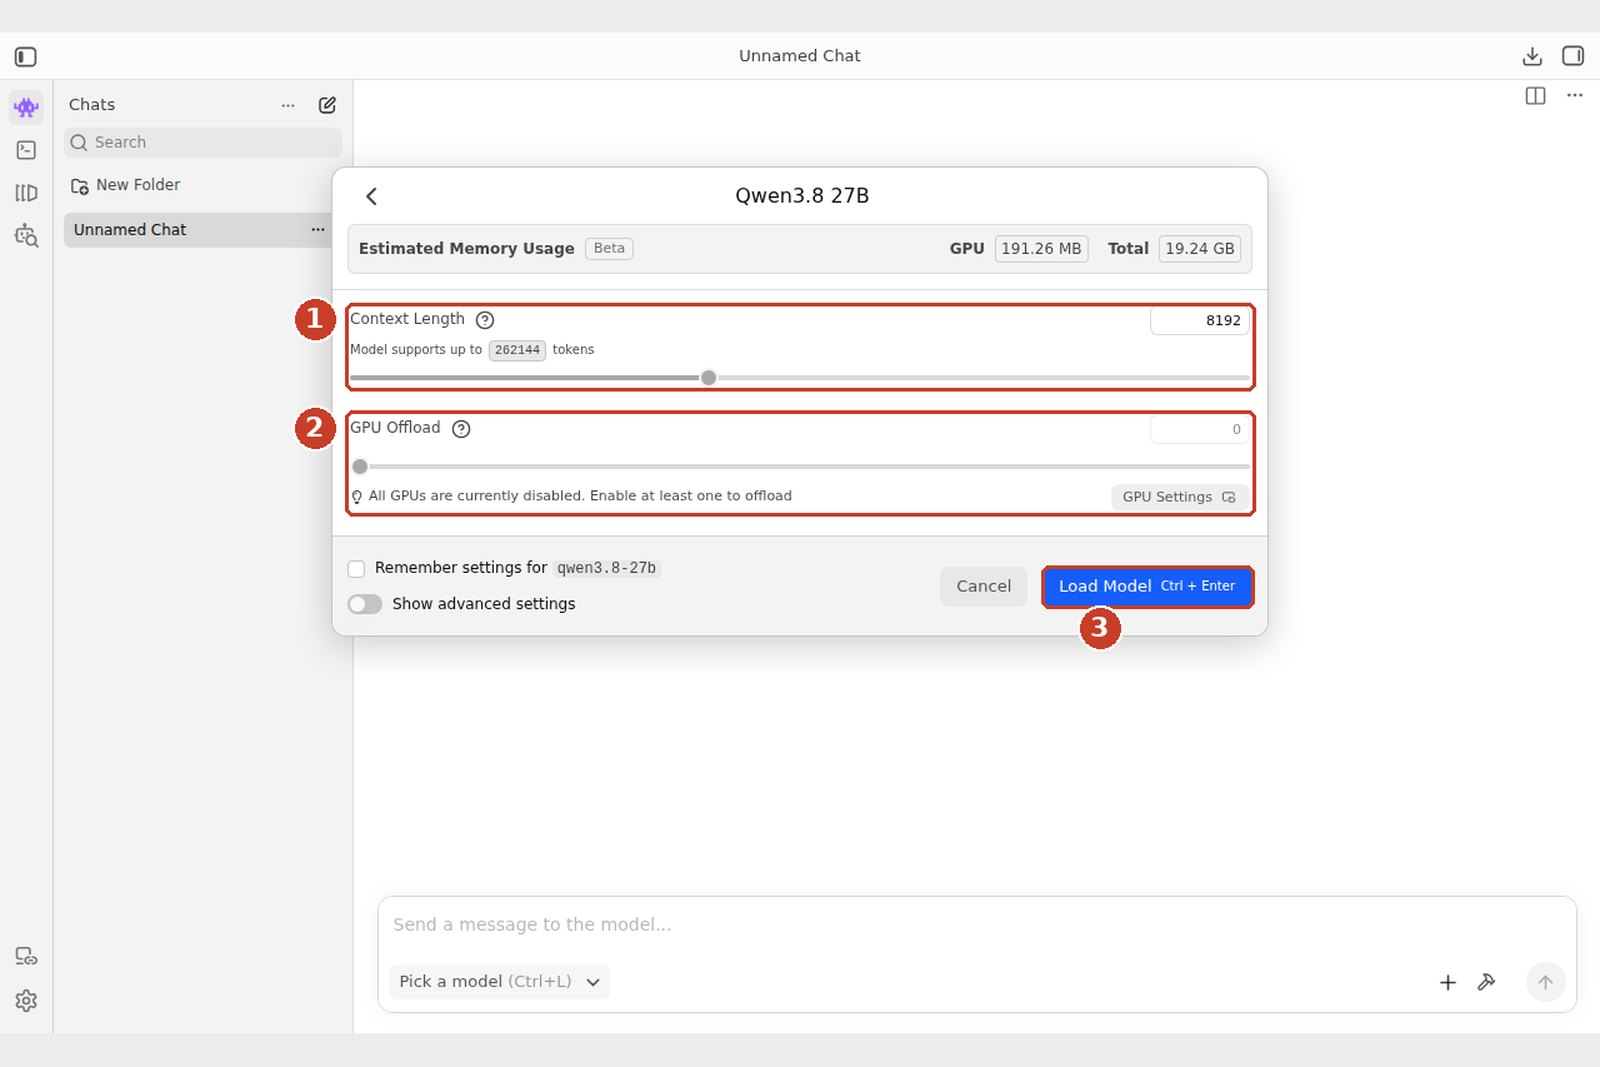
- Context Length … 一开始保持 8,192 就够了。要读长文档时再调大(内存也会增加)。
- GPU Offload … 有 GPU 的机器拉到最右(全部层)。全部放上去最快,放不下的部分在 CPU 上跑,会变慢。
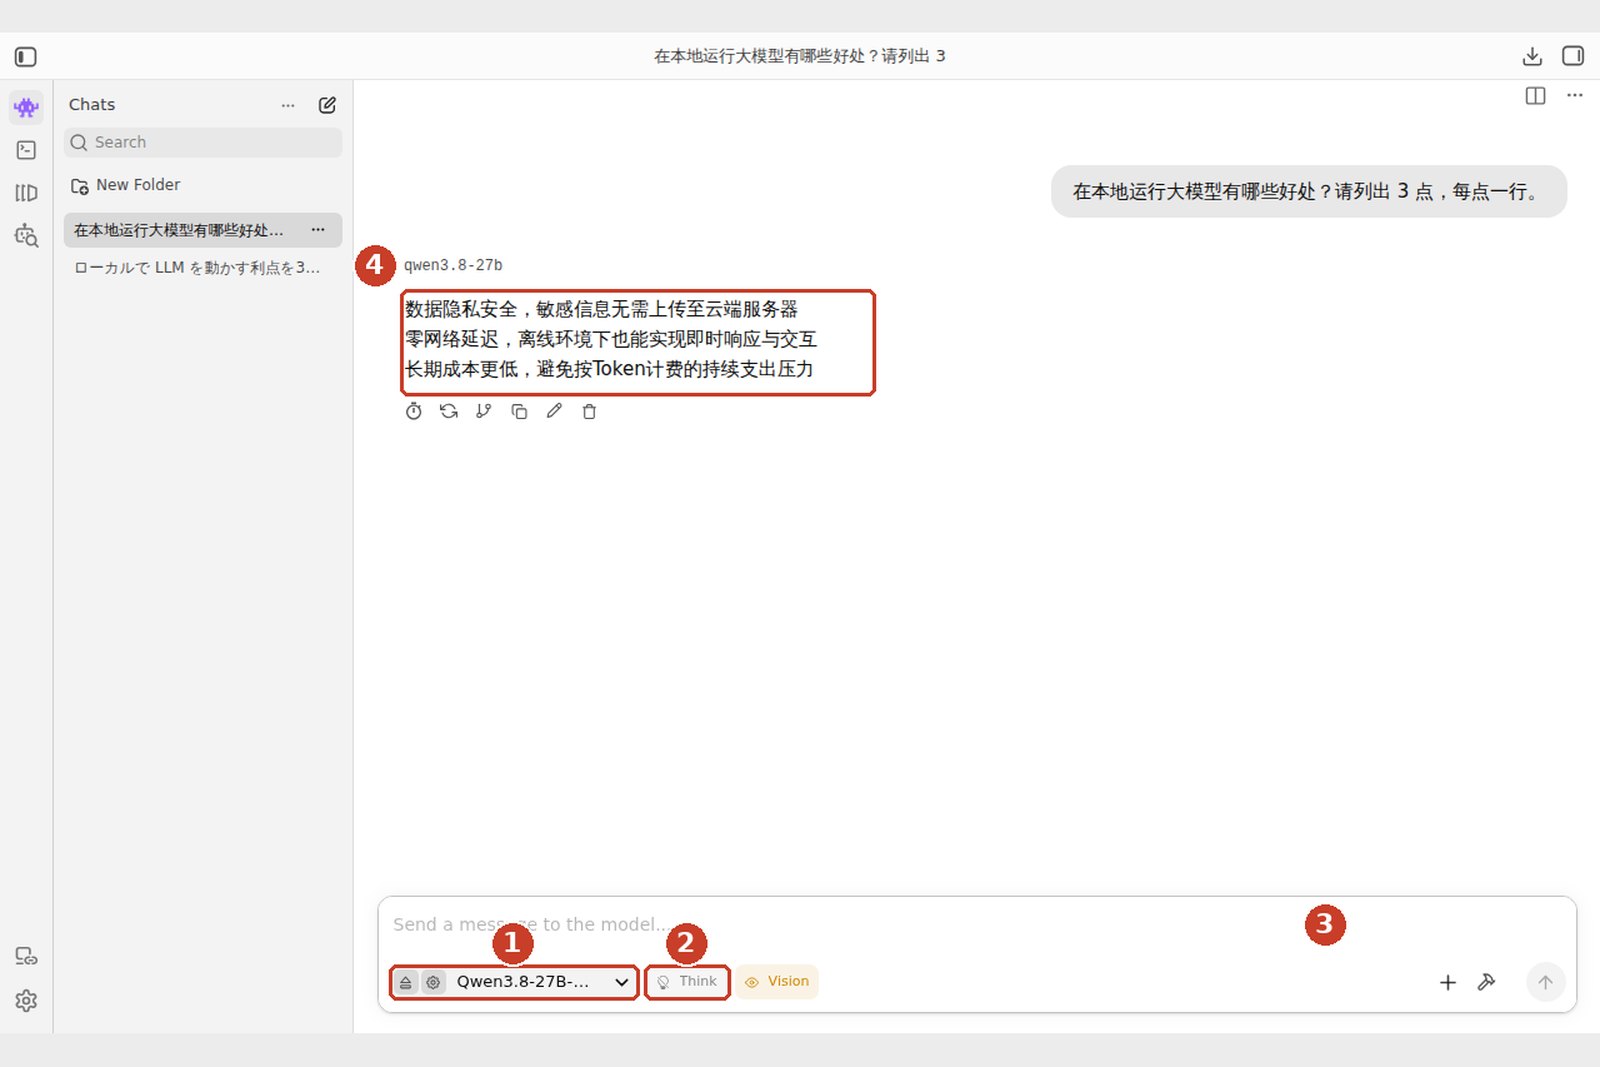
加载完成后,输入框左边会显示模型名。接下来输入问题按 Enter 即可。点输入框的 Think 可以开关“思考过程”。难题打开,日常对话关掉更快更方便。
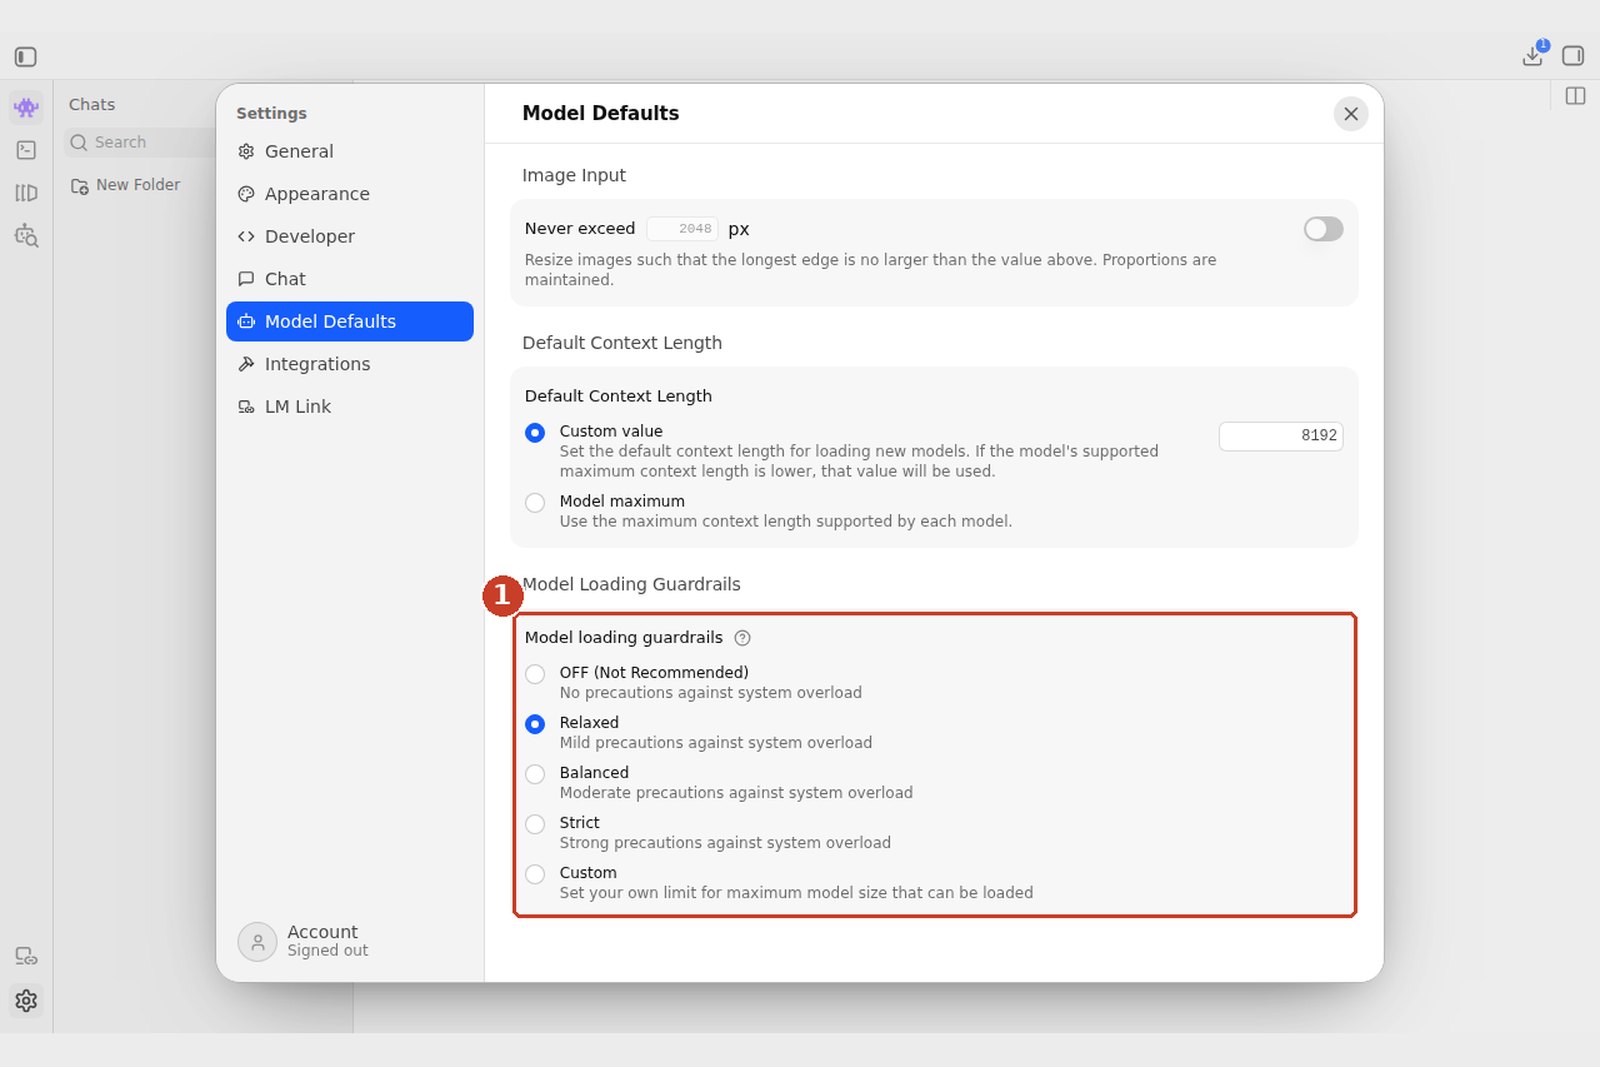
本文的截图是在一台没有 GPU、内存 8GB 的测试用 Linux 机器上拍的。27B 放不进内存,所以关掉了后面介绍的保护装置,让它一边从磁盘读取一边运行,每个 token 要几秒到十几秒。在 24GB 以上的显卡或 32GB 以上的 Mac 上,同样的操作就能流畅对话。
步骤 4:作为 API 使用(进阶)
LM Studio 还可以变成与 OpenAI API 相同调用方式的服务器。自己写的程序、支持 OpenAI 兼容 API 的工具,都能用上手边的模型。
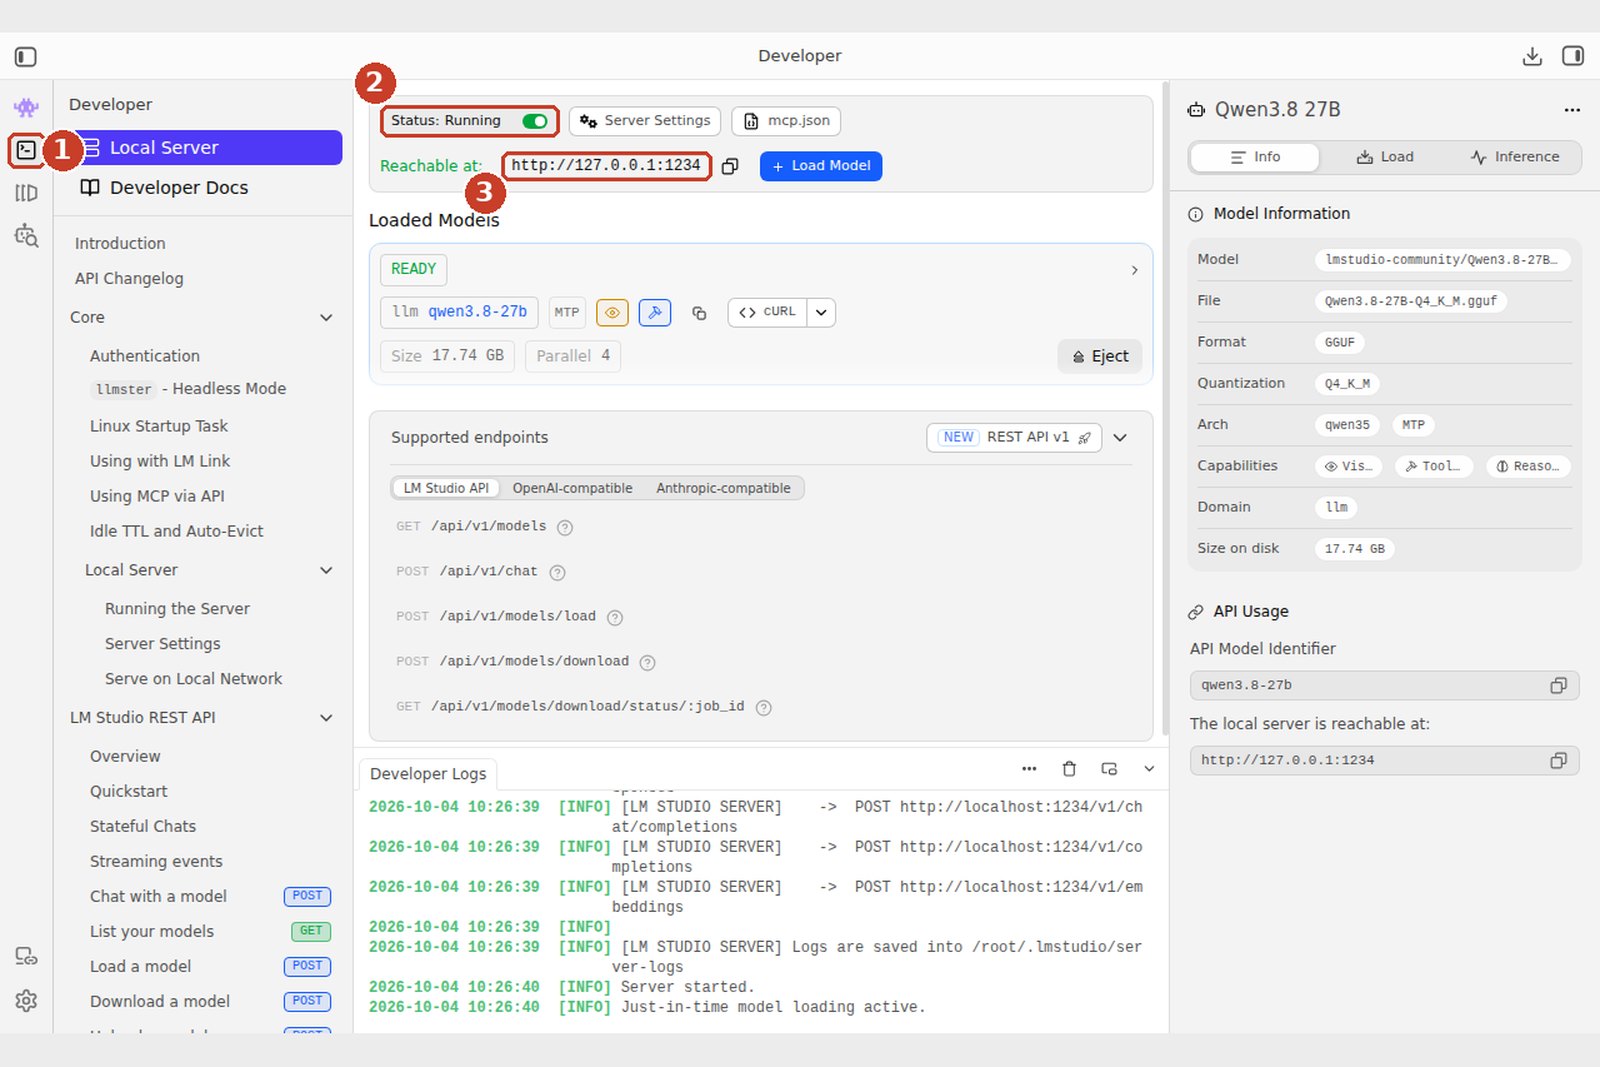
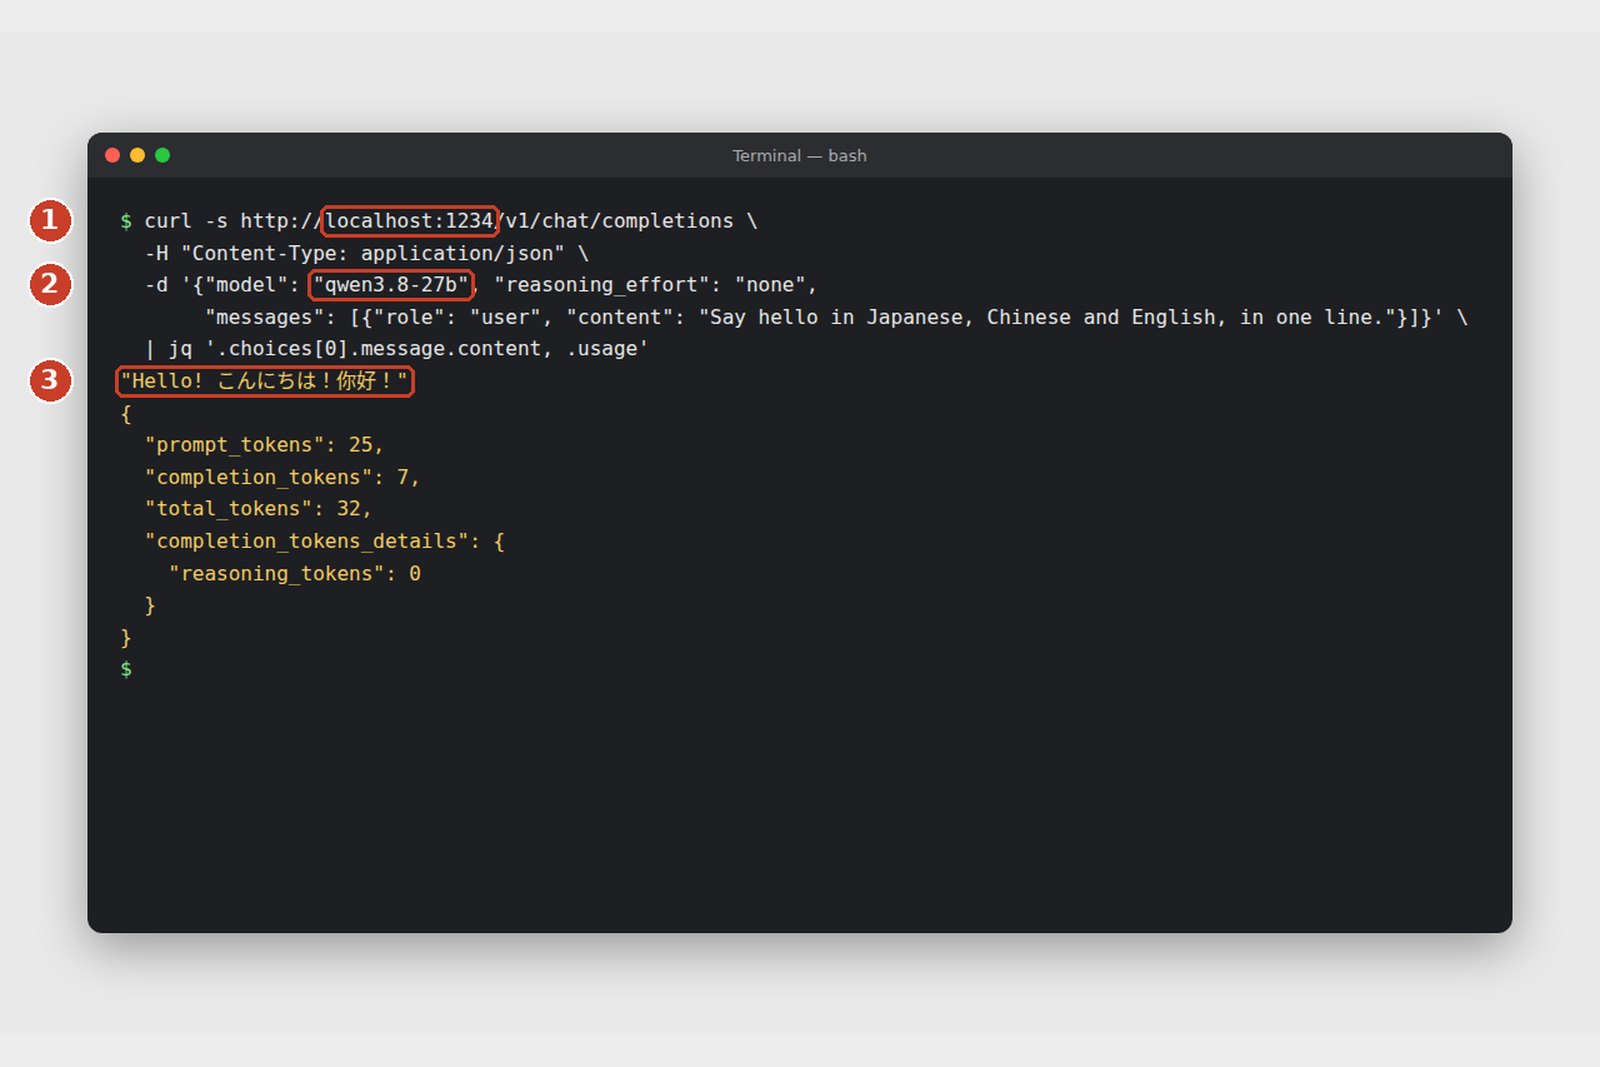
# 从终端发送问题(Windows 的 PowerShell 里写作 curl.exe)
curl http://localhost:1234/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{"model": "qwen3.8-27b", "reasoning_effort": "none",
       "messages": [{"role": "user", "content": "你好"}]}'
Qwen3.8 通过 API 调用时默认也会输出“思考过程”。加上 "reasoning_effort": "none",就会跳过思考直接回答(已在截图机上确认)。
不用界面的话,命令 lms 也能做同样的事(lms get 下载、lms load 加载、lms server start 启动服务器)。用 Ollama 的话,一行 ollama run qwen3.8 就能从下载一直走到对话。
遇到问题时
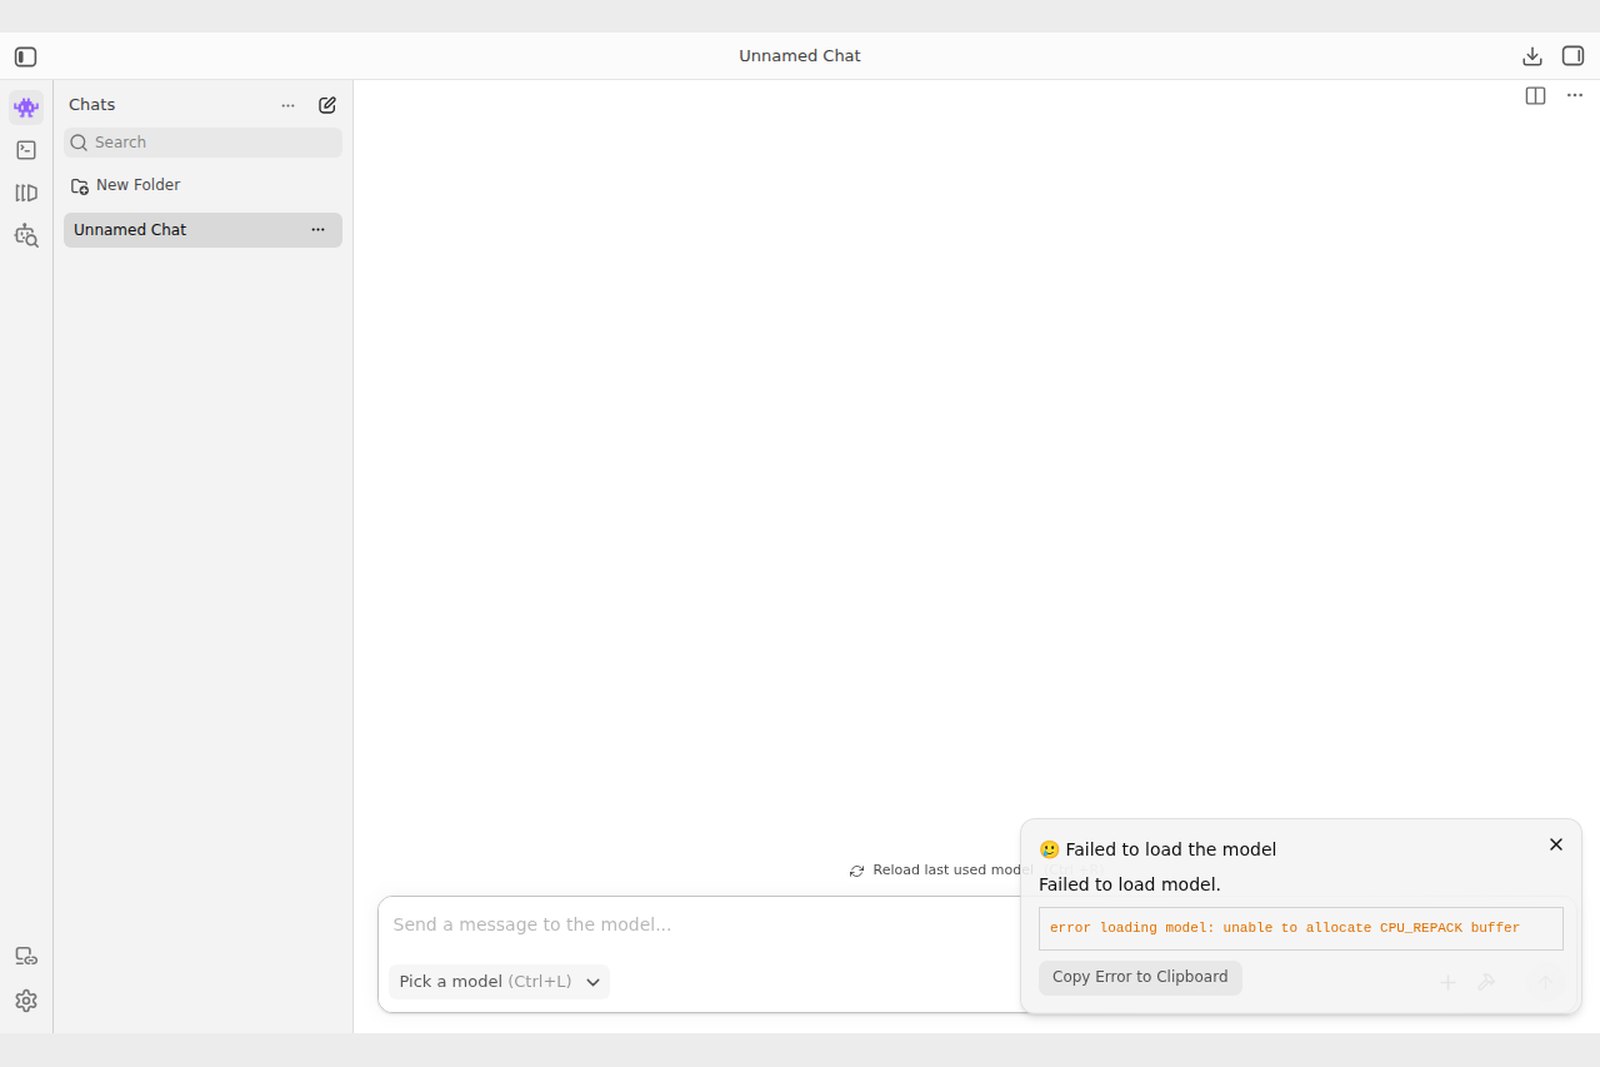
| 现象 | 原因 | 对策 |
|---|---|---|
| Likely too large/加载失败 | 内存不足 | 换更小的量化(Q4_K_M → Q3)或更小的模型(Gemma 4 12B),关掉其他应用 |
| 能加载但非常慢 | GPU 放不下,在 CPU 上跑 | GPU Offload 拉满;还不够就换小模型 |
| 长文档时卡住・变慢 | 上下文不够,或 KV 缓存导致内存不足 | 调大/调小 Context Length,把文档拆开 |
| 回答前想很久 | Thinking 处于打开状态 | 关掉 Think |
| Windows 上没用到 GPU | 驱动太旧・运行时不匹配 | 更新显卡驱动,在 LM Studio 的 Runtime 设置里选 CUDA(AMD 选 Vulkan) |
结 — 一页总结
- 本地运行的结构分为应用/引擎/指令体系/内存几层,“CUDA 系”“Metal 系”的区别在下面两层。
- NVIDIA(CUDA)胜在软件支持和速度,Mac(Metal・MLX)胜在大容量统一内存,AMD・Intel 可用 Vulkan 等。
- 内存估算:参数量 × 比特数 ÷ 8,27B 的 Q4_K_M 约 17GB。速度估算:内存带宽 ÷ 模型大小。
- 实用模型:文本 Qwen3.8・Gemma 4,图像 Z-Image・FLUX.2 klein,声音 Qwen3-TTS・VoxCPM2,OCR PaddleOCR-VL・GLM-OCR,翻译 Hy-MT2。
- 只选一个就选 Qwen3.8-27B。在 LM Studio 搜索 → 下载 Q4_K_M(Mac 用 MLX)→ 加载 → 对话,还能当 API 服务器用。
参考
- LM Studio — Download
- LM Studio Docs
- Ollama — Download
- Ollama — qwen3.8
- GitHub — ggml-org/llama.cpp
- GitHub — ml-explore/mlx
- Hugging Face — Qwen/Qwen3.8-27B
- Hugging Face — lmstudio-community/Qwen3.8-27B-GGUF
- Hugging Face — google/gemma-4-26B-A4B-it
- Hugging Face — openai/gpt-oss-20b
- Hugging Face — Tongyi-MAI/Z-Image-Turbo
- Hugging Face — black-forest-labs/FLUX.2-klein-4B
- Hugging Face — Qwen/Qwen-Image-2512
- Hugging Face — Qwen/Qwen3-TTS
- Hugging Face — openbmb/VoxCPM2
- Hugging Face — IndexTeam/IndexTTS-2.5
- Hugging Face — PaddlePaddle/PaddleOCR-VL-1.6
- Hugging Face — zai-org/GLM-OCR
- Hugging Face — deepseek-ai/DeepSeek-OCR-2
- Hugging Face — tencent/Hy-MT2-7B
- Hugging Face — google/translategemma-4b-it
- Hugging Face — pfnet/plamo-2-translate
LM Studio 的截图由笔者实际操作 LM Studio 0.4.25(Linux x64 版)拍摄,圆圈编号为事后叠加。模型的发布时间、大小和许可证以 2026 年 10 月 4 日 Hugging Face 官方页面为准。GPU 的内存带宽为厂商公布值,速度图为理论上限的估算。版本和界面可能会变化。
开发指南 No.4 — 在本地运行大模型 / 2026.10